Déployez Claude AI en entreprise
Structurez vos usages pour sécuriser vos données et gagner en efficacité
Vous avez testé Claude Code, Cursor et GitHub Copilot, et les benchmarks affichent des scores contradictoires selon la source consultée. Un développeur senior préfère parfois l’outil le moins bien classé, simplement parce qu’il s’intègre mieux à son flux de travail quotidien. Cette contradiction n’est pas un hasard : les scores de référence mesurent des tâches extrêmes, rarement représentatives du travail réel d’une équipe.
En 2026, choisir une IA pour coder ne se résume plus à lire un tableau de scores. Ce guide décrypte les benchmarks les plus récents, compare les outils dominants du marché et propose un choix concret selon votre profil, dev solo, équipe technique ou CTO. Il aborde aussi la sécurité, le RGPD et les erreurs les plus fréquentes observées lors d’un déploiement en entreprise.
Pourquoi utiliser une IA pour coder en 2026 ?
Les assistants IA de codage ne sont plus de simples gadgets réservés aux early adopters curieux de nouvelles technologies. Ils transforment concrètement les habitudes de travail des équipes techniques, sans pour autant remplacer le jugement humain. Voici ce qu’ils changent réellement, et ce qu’ils ne résolvent pas.
Ce que l'IA change concrètement dans un workflow de développement
Une IA pour coder réduit fortement le temps passé sur l’autocomplétion et la génération de code répétitif. Elle produit rapidement du boilerplate, des squelettes d’API ou des fonctions utilitaires standards. Un développeur écrit ainsi une route REST complète en quelques minutes, contre un quart d’heure auparavant.
Le débogage devient également plus rapide, car l’IA lit les journaux d’erreurs et propose directement des correctifs adaptés au contexte. Elle facilite aussi le refactoring de code ancien, souvent redouté par les équipes faute de documentation claire. La génération automatique de tests unitaires libère un temps précieux pour les tâches à plus forte valeur ajoutée.
Ces gains ne remplacent pas la réflexion technique, ils l’accélèrent. Un développeur expérimenté reste indispensable pour valider chaque suggestion produite par l’outil.
Limites et inconvénients réels des IA pour coder
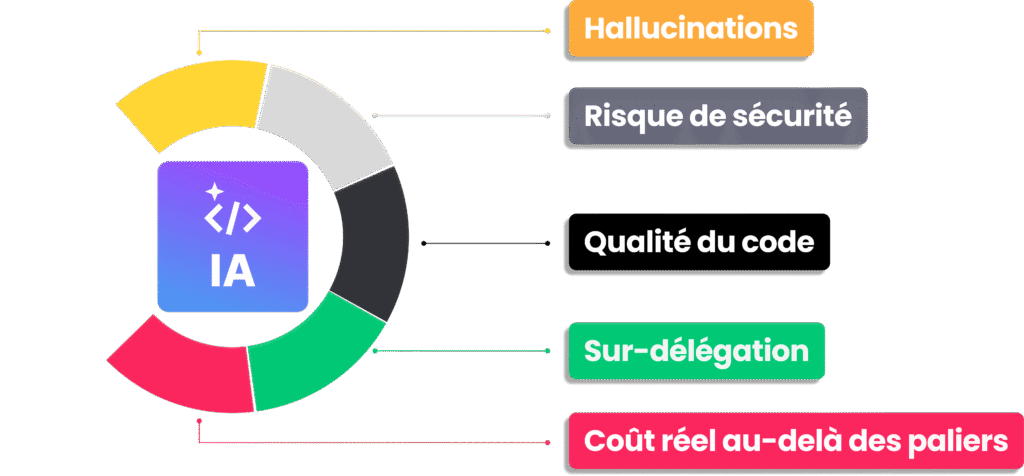
Les hallucinations restent le risque le plus documenté. Un modèle peut inventer un package inexistant ou référencer une méthode d’API qui n’a jamais existé. Installer un tel paquet sans vérification expose directement l’équipe à un risque de sécurité.
La qualité du code généré dépend fortement de la clarté du prompt fourni par le développeur. Un contexte flou produit un résultat flou, même avec le modèle le plus puissant du marché. Le code généré reste aussi difficile à auditer, car sa logique interne n’est pas toujours explicite.
Une sur-délégation excessive peut aussi affaiblir la vigilance technique de l’équipe sur le long terme. Enfin, ces outils ont un coût réel au-delà des paliers gratuits, qu’il faut intégrer dans un budget annuel. Une IA pour coder amplifie les compétences existantes, elle ne compense jamais un manque de rigueur.
Comment fonctionne une IA pour coder ?
Avant de choisir un outil, il est utile de comprendre les mécanismes techniques qui les distinguent réellement. Une IA pour coder repose sur trois grandes familles d’architecture, chacune avec ses propres forces.
Les modèles de langage derrière les outils de codage
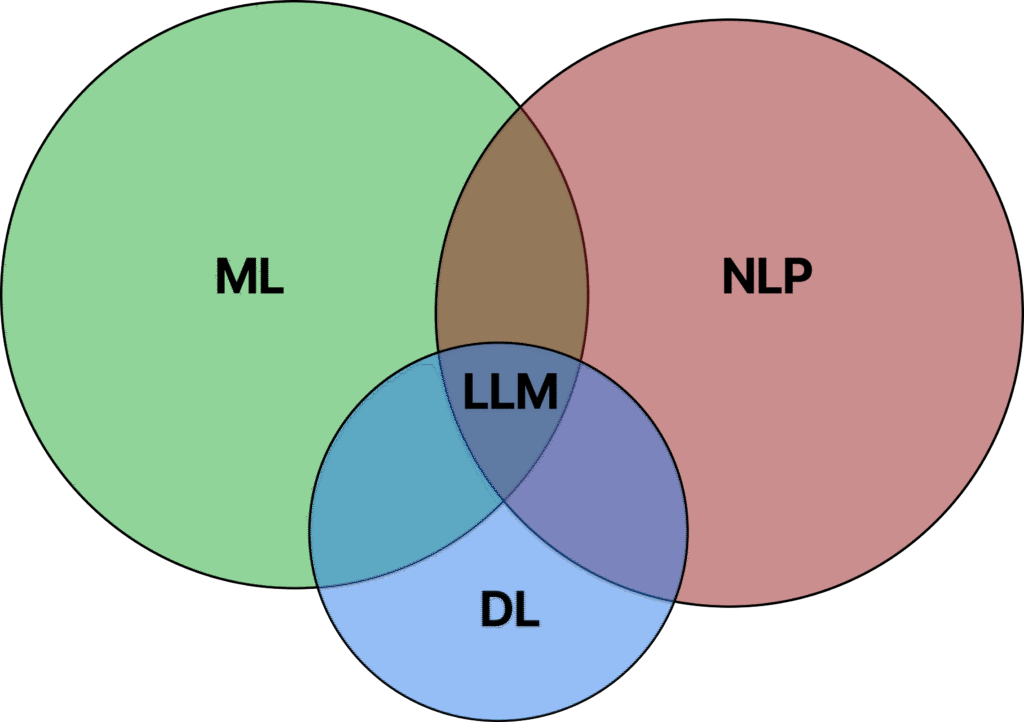
Les assistants de codage s’appuient sur de grands modèles de langage entraînés sur des milliards de lignes de code public. Des modèles comme Claude, ChatGPT ou Gemini sont ensuite affinés spécifiquement sur des corpus de programmation. Ce processus d’affinage améliore leur compréhension des conventions propres à chaque langage.
La fenêtre de contexte désigne la quantité de texte qu’un modèle peut analyser en une seule fois. Elle conditionne directement sa capacité à comprendre un projet complet plutôt que de simples extraits isolés. Selon l’annonce officielle d’Anthropic, Claude Opus 5 dispose désormais d’un million de tokens de contexte par défaut.
Les meilleurs outils combinent un modèle puissant, une large fenêtre de contexte et une récupération intelligente d’informations issues de votre propre base de code.
Chatbots IA (Claude, ChatGPT, Gemini) : raisonnement et génération
Les chatbots fonctionnent sur un mode conversationnel simple : vous posez une question, le modèle répond avec une explication détaillée. Cette approche convient parfaitement pour comprendre un bloc de code avant de l’implémenter dans un projet réel. Elle reste aussi précieuse pour obtenir un second avis technique rapide.
Claude, GPT-5.5 et Gemini 3.1 Pro dominent aujourd’hui cette catégorie, chacun avec des priorités produit différentes. L’inconvénient principal reste l’absence d’exécution autonome : le code doit être copié manuellement dans l’environnement de développement. Un chatbot reste donc préférable pour la réflexion, moins adapté pour automatiser des tâches répétitives à grande échelle.
Agents de codage autonomes (Claude Code, Codex, Devin) : exécution longue durée
Les agents autonomes exécutent directement du code, analysent les résultats obtenus et corrigent leurs propres erreurs sans intervention humaine constante. Claude Code s’appuie sur le protocole MCP pour accéder au terminal, à Git et aux fichiers du projet. Cette architecture lui permet de gérer des tâches complexes réparties sur plusieurs fichiers.
D’après TechCrunch, la fonctionnalité « Agent Teams » introduite avec Claude Opus 4.6 permet de répartir une tâche complexe entre plusieurs agents coordonnés. Codex, l’agent développé par OpenAI, mise sur une forte efficacité sur les tâches backend de longue durée. Devin va encore plus loin, en gérant un projet complet du début à la fin sans supervision continue.
Ces agents conviennent parfaitement au refactoring de grandes bases de code ou à l’automatisation de tests répétitifs. Leur principal inconvénient reste une transparence réduite : le raisonnement intermédiaire du modèle est moins visible qu’avec un chatbot classique.
IDE et extensions IA (Cursor, Windsurf, GitHub Copilot) : intégration dans l'éditeur
Ces outils vivent directement dans l’environnement de développement, sans changement de contexte pour le développeur. Cursor s’appuie sur plusieurs modèles frontière en arrière-plan et propose une autocomplétion sensible à l’ensemble du projet ouvert. Windsurf ajoute une couche d’anticipation via sa fonctionnalité Cascade, qui propose des modifications avant même la demande explicite.
GitHub Copilot reste l’extension IA la plus répandue, grâce à son intégration native avec VS Code, JetBrains et Neovim. Son principal atout tient à l’accès direct aux dépôts GitHub de l’équipe, utilisés comme contexte de génération. L’inconvénient commun à cette catégorie reste une flexibilité plus limitée que celle d’un agent autonome indépendant.
Comparatif des meilleures IA pour coder en 2026
Voici les outils qui dominent aujourd’hui le marché du développement assisté par IA. Chacun cible un usage précis, et le « meilleur » outil dépend surtout de votre stack technique et de votre profil professionnel.
Langages de programmation supportés : qui couvre quoi ?
La majorité des outils couvrent correctement Python, JavaScript, TypeScript, Go, Rust, Java et SQL sans difficulté notable. Les écarts apparaissent surtout sur les langages moins répandus comme Kotlin, Elixir ou Clojure. Claude Code se distingue particulièrement sur Python et Go, tandis que Copilot excelle davantage sur l’écosystème JavaScript.
Le tableau ci-dessous récapitule, pour chaque outil, ses langages forts, ses limites et son usage idéal.
| Outil | Langages forts | Langages plus limités | Idéal pour |
|---|---|---|---|
|
Claude Code |
Python, Go, TypeScript, SQL |
Kotlin, Elixir |
Refactoring complexe, agents autonomes |
|
Cursor |
JavaScript/TypeScript, Python, Go |
Clojure, Haskell |
Dev solo, équipes réduites |
|
GitHub Copilot |
JavaScript/TypeScript, Python, Java |
Rust, Go (moins bon) |
Autocomplétion, équipes GitHub |
|
GPT-5.5 / ChatGPT |
Tous langages (généraliste) |
Moins spécialisé sur le niche |
Explication, débogage |
|
Windsurf |
Python, JavaScript, Go |
Langages très spécifiques |
Productivité IDE, conformité |
|
Gemini Code Assist |
Python, Java, Go |
Support variable selon langage |
Écosystème Google Cloud |
Claude Code domine sur les langages qui nécessitent un raisonnement complexe et une compréhension architecturale fine. Cursor et Copilot restent particulièrement performants sur l’écosystème web JavaScript et TypeScript. Le choix final dépend surtout de la stack technique déjà déployée dans votre équipe.
Claude Code : raisonnement complexe et agents autonomes
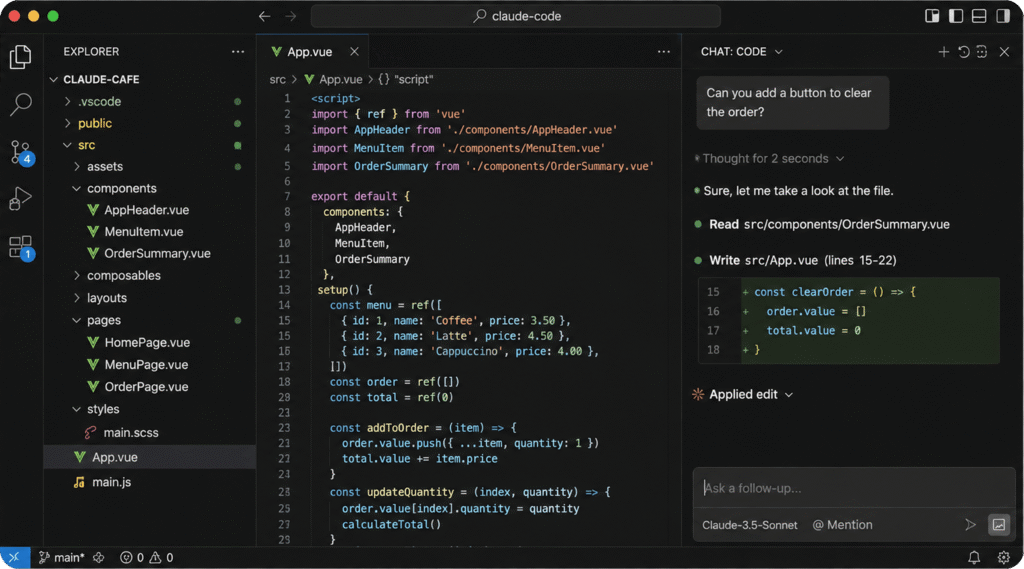
Claude Code, développé par Anthropic, s’appuie sur les modèles Opus et Sonnet les plus récents, associés au protocole MCP. D’après l’annonce officielle publiée par Anthropic, Claude Opus 5 obtient un score de 96,0 % sur SWE-bench Verified. Ce score en fait aujourd’hui l’un des modèles les plus performants du marché sur les tâches d’ingénierie logicielle réelles.
Ses avantages incluent une fenêtre de contexte d’un million de tokens disponible par défaut, des agents capables d’itérer seuls, et un raisonnement transparent et détaillé. Ses limites concernent un coût plus élevé que la moyenne du marché, et une configuration initiale du protocole MCP parfois technique. Claude Code convient particulièrement au refactoring de bases de code volumineuses et aux équipes techniques exigeantes qui recherchent l’autonomie.
Cursor : l'IDE IA pour les développeurs exigeants
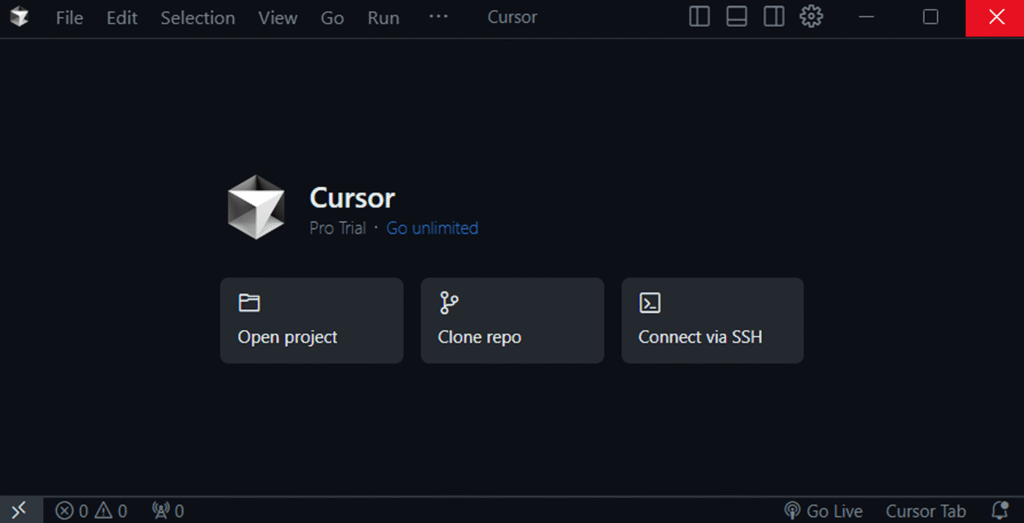
Cursor est un éditeur basé sur VS Code, enrichi de plusieurs modèles frontière accessibles directement depuis l’interface. Il offre une autocomplétion intelligente et un accès complet au code du projet via une récupération contextuelle avancée. Depuis 2026, sa facturation fonctionne par crédits d’usage plutôt que par simple abonnement forfaitaire fixe.
Le plan Pro démarre à 20 euros mensuels, le plan Pro+ à 60 euros, et l’offre Ultra à 200 euros par mois. Pour les équipes, le siège Teams Standard coûte 40 euros par utilisateur, contre 120 euros pour le siège Premium destiné aux gros usages. Cursor reste particulièrement adapté aux développeurs solo et aux petites équipes qui privilégient l’intégration native dans l’éditeur.
GitHub Copilot : l'intégration native pour les équipes
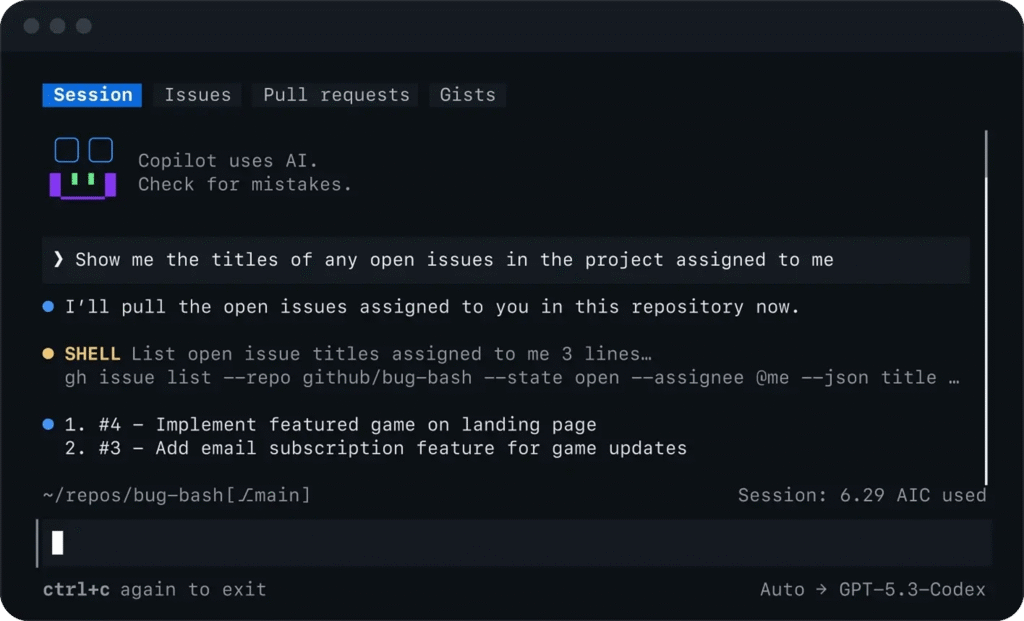
Copilot reste l’extension IA la plus installée au monde, portée par son intégration profonde avec l’écosystème GitHub. Depuis juin 2026, sa facturation repose sur des crédits d’usage appelés AI Credits, comme l’explique le blog officiel de GitHub. Le plan Pro individuel coûte désormais 10 euros mensuels, contre 39 euros pour le plan Pro+ destiné aux usages intensifs.
Côté entreprise, le plan Business est facturé 19 euros par utilisateur, et le plan Enterprise 39 euros par utilisateur. Ce dernier ajoute l’indexation complète du code source et un accès prioritaire aux modèles les plus récents. Copilot convient parfaitement aux équipes déjà organisées autour de GitHub, avec un besoin fort d’autocomplétion quotidienne.
Windsurf : l'IDE IA orienté conformité et productivité
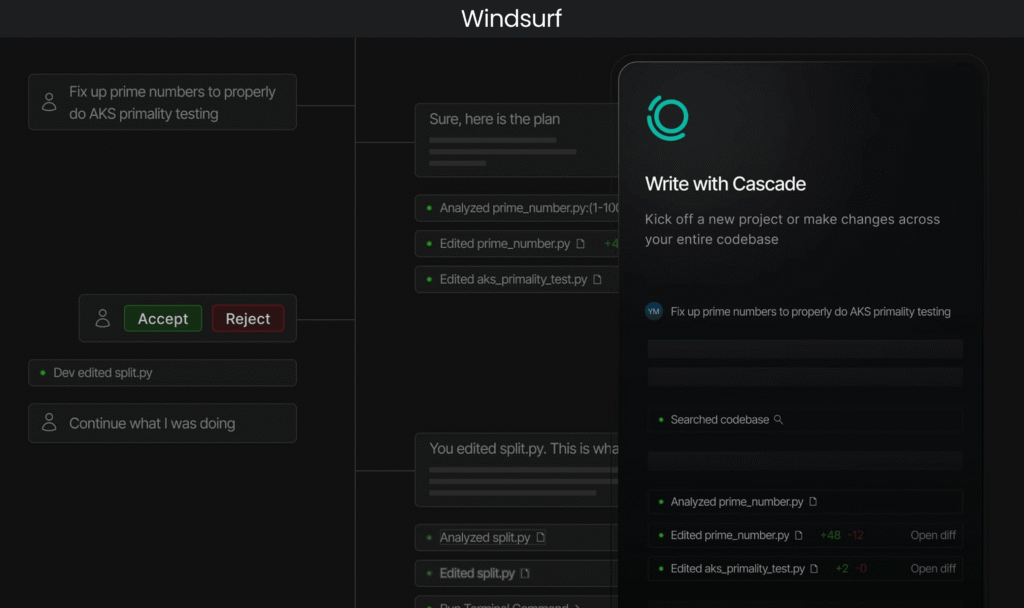
Windsurf se positionne comme un éditeur IA qui mise sur deux priorités distinctes, la productivité quotidienne et la conformité réglementaire. Sa fonctionnalité phare, nommée Cascade, ne se limite pas à compléter du code existant. Elle anticipe activement la prochaine action du développeur et propose des modifications proactives sur plusieurs fichiers.
L’outil prend en charge plus de soixante-dix langages différents et s’installe rapidement sur la majorité des environnements de développement. Son atout distinctif face à Cursor réside dans une compatibilité IDE plus large, avec des plugins pour plus de quarante environnements. Windsurf convient particulièrement aux équipes qui recherchent à la fois productivité et exigences de conformité renforcées.
Gemini Code Assist : l'option pour l'écosystème Google Cloud
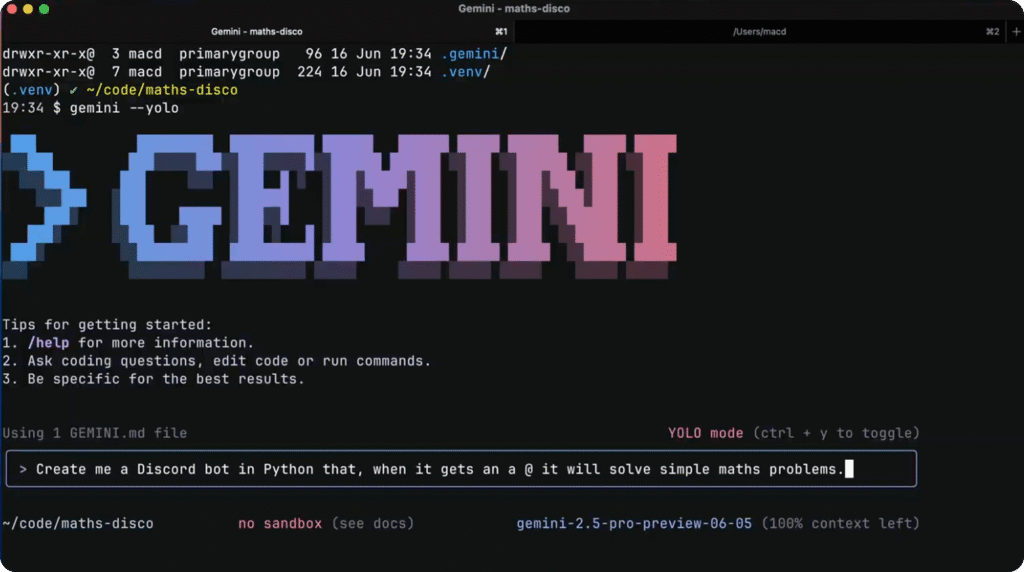
Gemini Code Assist s’appuie sur les modèles Gemini de Google, dont la version 3 Pro affiche aujourd’hui la plus large fenêtre de contexte du marché. Elle atteint deux millions de tokens, un avantage net sur les très grandes bases de code multi-projets. L’outil s’intègre nativement avec Google Cloud, BigQuery et l’ensemble des services de l’écosystème Google.
Cette intégration profonde en fait un choix naturel pour les équipes déjà engagées dans une infrastructure Google Cloud existante. Sa contrepartie reste une pertinence moindre pour les équipes qui travaillent principalement sur AWS ou Azure. Gemini Code Assist convient donc avant tout aux organisations dont l’infrastructure cloud repose déjà sur Google.
Tabnine : la solution on-premise pour la confidentialité stricte
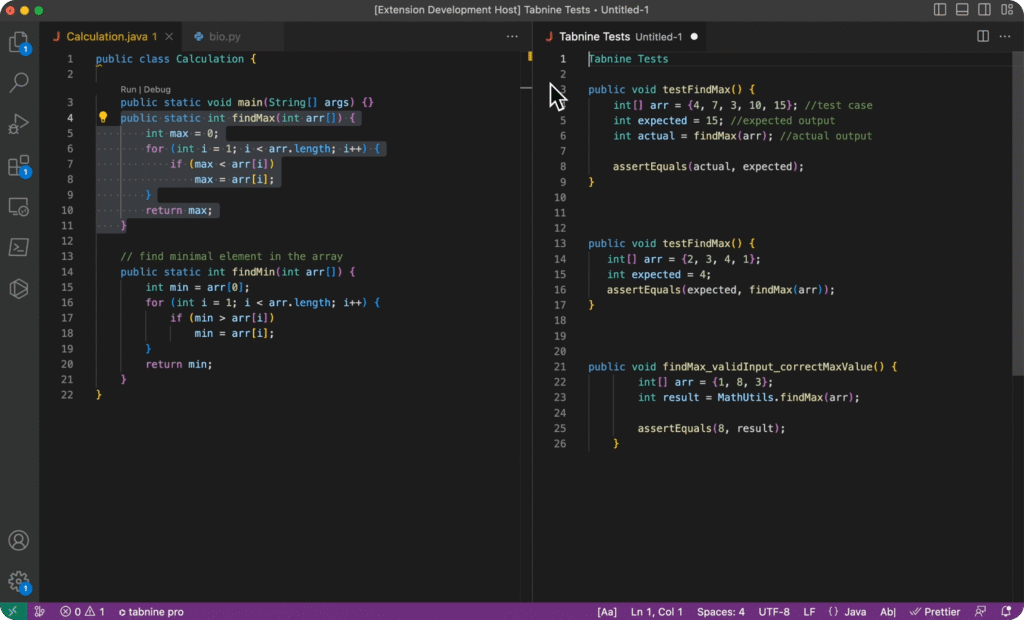
Tabnine se distingue par sa capacité à fonctionner entièrement en déploiement local, sans envoyer aucune donnée vers un serveur externe. Cette approche répond directement aux besoins des secteurs les plus sensibles, comme la finance, la santé ou la défense. L’outil sacrifie une partie de la puissance brute des modèles frontière au profit d’une confidentialité totale.
Il convient particulièrement aux équipes soumises à des contraintes réglementaires strictes, où le code ne doit jamais quitter le périmètre de l’entreprise. Cette section rejoint directement les enjeux de conformité détaillés plus loin dans cet article, dans la partie consacrée à la sécurité et au RGPD.
ChatGPT et Codex (OpenAI) : deux outils, deux usages
OpenAI propose deux produits bien distincts pour accompagner le développement logiciel. ChatGPT, propulsé par GPT-5.5, fonctionne en mode conversationnel classique pour expliquer, déboguer et refactoriser du code existant. Codex, de son côté, agit comme un agent autonome capable d’exécuter et d’itérer sans supervision constante.
Codex s’appuie sur GPT-5.5 et bénéficie d’une fenêtre de contexte de 400 000 tokens dans son environnement dédié, contre un million de tokens via l’API. Ses points forts résident dans son efficacité sur les tâches backend et sa bonne gestion des workflows longue durée. ChatGPT reste préférable pour la réflexion et l’explication, Codex pour l’automatisation de tâches techniques répétitives.
Alternatives open source et on-premise : DeepSeek, Llama, Tabnine
Les modèles open source comme DeepSeek ou Llama offrent un rapport coût-bénéfice particulièrement attractif pour les équipes au budget contraint. Leur coût d’utilisation reste largement inférieur à celui des modèles propriétaires, avec la possibilité d’un déploiement entièrement local. Cette flexibilité séduit les entreprises qui refusent toute dépendance envers un fournisseur cloud unique.
Leur contrepartie reste des performances généralement inférieures aux modèles frontière sur les tâches de raisonnement complexe. Le support technique disponible est aussi plus limité que celui proposé par les grands éditeurs commerciaux. Ces solutions conviennent avant tout aux startups au budget serré et aux équipes qui exigent un déploiement strictement on-premise.
Benchmarks IA pour coder : ce que les scores révèlent vraiment
Les benchmarks SWE-bench et Terminal-Bench reviennent constamment dans les comparatifs publiés en 2026. Ces chiffres méritent pourtant d’être interprétés avec prudence, avant de fonder une décision d’achat entière sur un seul score.
SWE-bench et Terminal-Bench : comment lire ces chiffres
SWE-bench Verified mesure la capacité d’un modèle à résoudre de véritables problèmes issus de dépôts GitHub réels. Terminal-Bench évalue quant à lui l’exécution de commandes shell dans un environnement de développement authentique. Selon l’annonce officielle d’Anthropic, Claude Opus 5 obtient 96,0 % sur SWE-bench Verified, le score public le plus élevé publié à ce jour.
OpenAI, de son côté, ne communique plus de score SWE-bench Verified pour ses modèles récents, invoquant un risque de mémorisation qui fausserait les résultats. Selon la page officielle de lancement de GPT-5.5, OpenAI publie désormais son score sur SWE-bench Pro, une variante jugée plus résistante à la triche. Cette différence de méthodologie explique pourquoi une comparaison directe et unique entre tous les outils reste difficile à établir.
Ces scores portent principalement sur des tâches complexes, comme un refactoring architectural ou une résolution de bug difficile. Pour l’autocomplétion quotidienne, la majorité des outils du marché offrent des résultats globalement comparables entre eux. La fenêtre de contexte compte souvent davantage que le score brut affiché sur un tableau comparatif isolé.
Performances terrain vs performances marketing
Les benchmarks ne reflètent pas toujours la réalité vécue par une équipe technique au quotidien. Une équipe de vingt développeurs peut préférer Copilot pour son intégration GitHub, malgré un score inférieur aux modèles concurrents. Un autre exemple concerne ChatGPT, souvent préféré pour son interface simple malgré un score de raisonnement moins élevé.
Ces benchmarks testent surtout des cas extrêmes, rarement représentatifs des tâches quotidiennes comme le débogage rapide. Utilisez ces scores comme un signal indicatif, jamais comme une vérité absolue et définitive. Testez systématiquement l’outil sur vos propres cas d’usage avant toute décision d’achat définitive.
Tableau benchmarks 2026 (sources vérifiées)
Voici une synthèse des principaux résultats publiés par les éditeurs eux-mêmes début 2026. Ces chiffres évoluent rapidement, une vérification régulière auprès des sources officielles reste recommandée.
| Outil | Dernière version | SWE-bench Pro (public) | Fenêtre de contexte |
|---|---|---|---|
|
Claude Opus 5 |
Juillet 2026 |
79,2 % |
1 million de tokens |
|
GPT-5.5 (Codex) |
Avril 2026 |
58,6 % |
1 million de tokens (API) |
|
Gemini 3.1 Pro |
2026 |
54,2 % |
2 millions de tokens |
Claude domine actuellement sur le raisonnement et l’autonomie agentique selon les données publiées par Anthropic. Gemini 3.1 Pro conserve la fenêtre de contexte la plus large du marché en 2026. Votre priorité, raisonnement, coût ou taille de contexte, doit guider le choix final entre ces outils.
Faut-il choisir un seul outil ou en combiner plusieurs ?
La tendance dominante observée en 2026 ne consiste plus à choisir un seul outil unique et définitif. La majorité des équipes techniques combinent aujourd’hui plusieurs solutions complémentaires selon la nature de chaque tâche.
Un assistant intégré à l’éditeur, comme Cursor ou Copilot, gère efficacement les tâches quotidiennes d’autocomplétion et de suggestions rapides. Un agent autonome, comme Claude Code ou Codex, prend le relais sur les missions complexes qui nécessitent plusieurs itérations successives. Un outil de revue de sécurité complète enfin la chaîne, avant toute mise en production du code généré.
Cette stratégie évite de forcer un seul outil à couvrir des besoins très différents entre eux. Imposer Copilot à un développeur senior qui refactorise en profondeur réduit sa productivité de manière mesurable. À l’inverse, imposer Claude Code à un développeur junior qui découvrent à peine son environnement peut créer une sous-utilisation de l’outil.
La question à se poser n’est donc plus « quel outil choisir », mais plutôt « quelle combinaison correspond à mon équipe ». Cette approche demande un budget légèrement plus élevé, mais elle maximise le retour sur investissement de chaque outil déployé.
Comment choisir une IA pour coder ?
Vous avez désormais les benchmarks et le comparatif complet des outils disponibles sur le marché. Reste à déterminer quels critères comptent vraiment pour votre contexte précis, et à identifier le guide adapté à votre profil professionnel.
Les critères déterminants pour choisir son outil IA
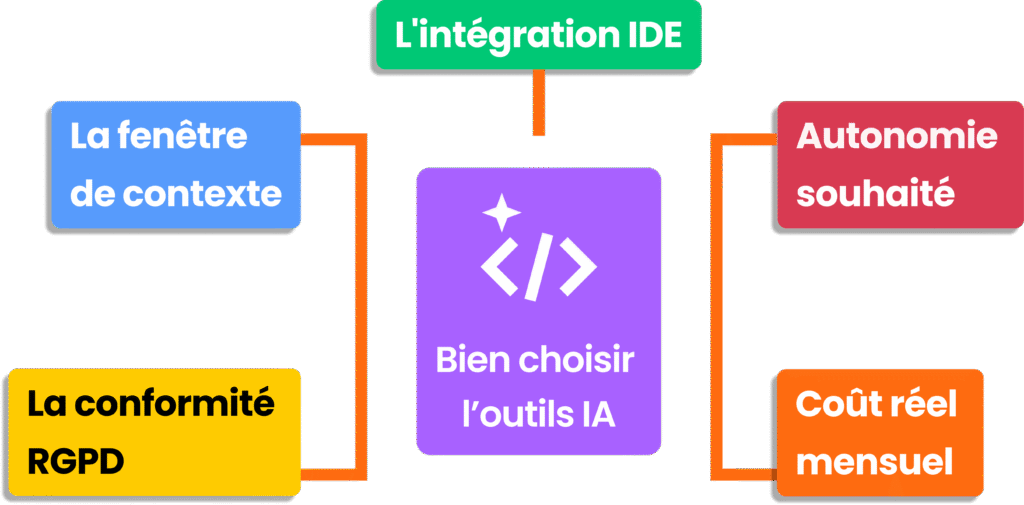
Cinq critères principaux doivent guider votre choix final entre les différents outils disponibles. L’intégration IDE détermine si vous préférez un chatbot séparé ou une intégration directe dans votre éditeur habituel. La fenêtre de contexte compte particulièrement pour les grandes bases de code, où Claude et Gemini dominent nettement le marché actuel.
Le niveau d’autonomie souhaité oriente aussi le choix, entre un agent qui exécute seul et une autocomplétion simplement guidée. La conformité RGPD reste décisive pour les entreprises françaises qui manipulent des données sensibles ou réglementées. Le coût réel mensuel par développeur doit enfin être calculé précisément avant tout engagement à long terme.
Ces critères doivent être hiérarchisés collectivement en équipe, plutôt que décidés unilatéralement par une seule personne.
Développeur solo ou freelance
Un développeur indépendant privilégie généralement la productivité maximale associée à un coût mensuel contenu. Cursor, avec son intégration native dans l’éditeur, réduit fortement les changements de contexte pendant la journée de travail. Claude via l’API reste également pertinent pour un usage ponctuel et facturé strictement à la consommation réelle.
Un freelance qui gagne trente pour cent de temps quotidien libère un temps précieux pour de nouvelles missions clients. Pour ce profil, Cursor constitue généralement le choix le plus évident sur le marché actuel.
Équipe technique de cinq à cinquante développeurs
Une équipe technique de cette taille privilégie l’intégration collective, la conformité et un support réactif de l’éditeur. GitHub Copilot convient particulièrement si l’équipe travaille déjà intégralement sur l’écosystème GitHub existant. Claude Enterprise devient préférable dès qu’un raisonnement complexe ou une conformité RGPD stricte devient nécessaire.
Copilot gagne sur l’intégration native, où les dépôts de l’équipe servent directement de contexte de génération. Pour ces types d’équipes, Claude Enterprise gagne généralement sur la conformité réglementaire et sur la profondeur du raisonnement proposé par le modèle.
CTO ou tech lead en entreprise
Un CTO privilégie le raisonnement complexe, l’autonomie agentique, la conformité réglementaire et un support enterprise dédié. Claude Enterprise répond directement à ces exigences précises. Sa fenêtre de contexte étendue permet d’analyser une base de code entière plutôt que de simples fragments isolés.
Ce profil recherche avant tout un investissement stratégique de long terme, plutôt qu’une simple économie ponctuelle immédiate. Claude Enterprise constitue généralement l’investissement le plus pertinent pour ce type de décideur technique.
Débutant ou reconversion tech
Un développeur débutant recherche avant tout une compréhension claire, une interface simple et un coût d’entrée limité. ChatGPT séduit par sa polyvalence et sa capacité à expliquer chaque concept de manière pédagogique et accessible. Claude, accessible gratuitement via son interface web, propose quant à lui un raisonnement transparent particulièrement formateur.
Un débutant qui utilise ces outils pour déboguer progresse généralement plus vite qu’avec une simple recherche isolée. ChatGPT reste souvent l’outil pédagogique le plus adapté à ce profil d’apprentissage progressif.
Vous déployez une IA de codage en équipe ?
Chaque configuration soulève des questions différentes sur la conformité RGPD et le retour sur investissement réel.
IA gratuite pour coder : ce qui est vraiment gratuit
Le test d’un outil sans engagement financier reste une étape recommandée avant tout investissement significatif. Voici ce qui reste réellement accessible gratuitement, et les limites concrètes rencontrées une fois ce palier dépassé.
Outils IA gratuits pour coder : comparatif des paliers d'entrée
La majorité des éditeurs proposent aujourd’hui un palier gratuit, mais celui-ci reste volontairement limité en usage. Les restrictions portent généralement sur le nombre de requêtes, la fenêtre de contexte ou l’absence totale de support dédié.
Le tableau suivant compare, pour chaque outil, le palier gratuit, le premier palier payant et ses principales limites.
| Outil | Palier gratuit | Premier palier payant | Limites principales |
|---|---|---|---|
|
Claude (web) |
Usage limité quotidien |
Abonnement individuel |
Fenêtre réduite, pas d’accès API |
|
ChatGPT |
Usage limité par période |
Abonnement individuel |
Fenêtre réduite, pas d’accès API |
|
GitHub Copilot |
Gratuit avec limites, offre étudiante |
10 euros mensuels |
Accès agent et modèles premium limités |
|
Cursor |
Palier Hobby gratuit |
20 euros mensuels |
Crédits d’usage limités |
|
DeepSeek |
API gratuite avec quotas |
Facturation à l’usage |
Fenêtre de contexte réduite |
Claude et ChatGPT restent parfaitement adaptés pour une première prise en main sans engagement financier. Copilot propose une offre étudiante avantageuse, tandis que Cursor conserve un palier Hobby permanent, mais limité. Testez systématiquement chaque offre gratuite avant d’investir dans l’outil qui correspond réellement à votre usage quotidien.
Plans payants : quand le passage à la caisse se justifie
Le passage vers un abonnement payant se justifie dès que le gain de productivité dépasse clairement son coût mensuel. Un développeur solo qui gagnant 30% de temps quotidien avec Cursor rentabilise très largement l’abonnement engagé. Une équipe de 20 développeurs équipée de Copilot amortit rapidement son coût via la réduction du temps de développement.
Un CTO qui déploie Claude Enterprise pour refactoriser une base de code volumineuse observe généralement un gain de temps considérable. Investir dans une IA pour coder devient rentable dès lors que l’outil est réellement utilisé au quotidien. Testez d’abord sur un projet pilote limité, puis étendez l’investissement progressivement selon les résultats observés.
Vous déployez Claude Code en entreprise ?
Parlons de votre architecture, votre stack et vos contraintes de conformité. Notre équipe partenaire certifié Anthropic vous accompagne de la configuration au déploiement.
Sécurité et RGPD : ce que le code généré par IA implique vraiment
La vitesse de génération ne garantit jamais automatiquement la sécurité du code produit par un modèle. Vos données restent-elles réellement confidentielles pendant l’utilisation de ces outils au quotidien ? Voici les risques concrets identifiés et les mesures permettant de les limiter efficacement.
Risques réels : hallucinations de packages, injection, fuite de données
Trois risques majeurs concernent directement les équipes qui déploient une IA de codage en production. Les hallucinations de packages restent le premier danger. Un modèle peut inventer une dépendance qui n’existe nulle part. Installer ce paquet fictif expose directement l’équipe à l’installation involontaire d’un logiciel malveillant.
L’injection SQL ou XSS représente un second risque. Un prompt flou peut produire du code vulnérable sans que l’équipe ne le remarque. La fuite de données constitue enfin un risque majeur. Certains fournisseurs peuvent réutiliser le code envoyé pour entraîner leurs futurs modèles. Auditez systématiquement chaque ligne de code généré, en complément d’un outil d’analyse statique dédié comme SonarQube.
Quels outils sont conformes RGPD pour les équipes en France ?
Claude Enterprise propose un hébergement européen des données ainsi qu’un contrat DPA signé, ce qui garantit l’absence d’entraînement sur vos données propriétaires. Cette conformité en fait aujourd’hui l’un des choix les plus solides pour les équipes françaises soumises au RGPD. GitHub Copilot Business propose également un contrat DPA, avec des données historiquement hébergées principalement aux États-Unis.
ChatGPT Enterprise applique une politique similaire, sans entraînement sur les données transmises par l’entreprise cliente. Les solutions open source hébergées hors Union européenne restent généralement les moins adaptées à une conformité RGPD stricte. Vérifiez systématiquement le lieu d’hébergement des données avant tout déploiement en environnement professionnel réglementé.
Checklist sécurité avant de déployer une IA de codage en entreprise
Avant tout déploiement en équipe, plusieurs points doivent être vérifiés méthodiquement pour limiter les risques identifiés précédemment.
- Vérifiez la conformité RGPD et l’existence d’un contrat DPA signé avec l’éditeur.
- Auditez systématiquement le code généré via un outil d’analyse statique reconnu.
- Contrôlez que l’outil n’a jamais accès à des secrets ou clés API sensibles.
- Définissez une gouvernance claire précisant qui peut utiliser l’outil, et sur quels projets.
- Formez l’équipe au prompting précis et à l’audit systématique du code produit.
- Mettez en place un suivi d’usage pour tracer qui utilise l’outil, et sur quoi.
Cette checklist doit être révisée régulièrement, car les risques évoluent avec les capacités croissantes des modèles. La sécurité ne constitue jamais un frein au déploiement, elle en est plutôt un prérequis indispensable.
Erreurs fréquentes observées lors du déploiement d'une IA pour coder
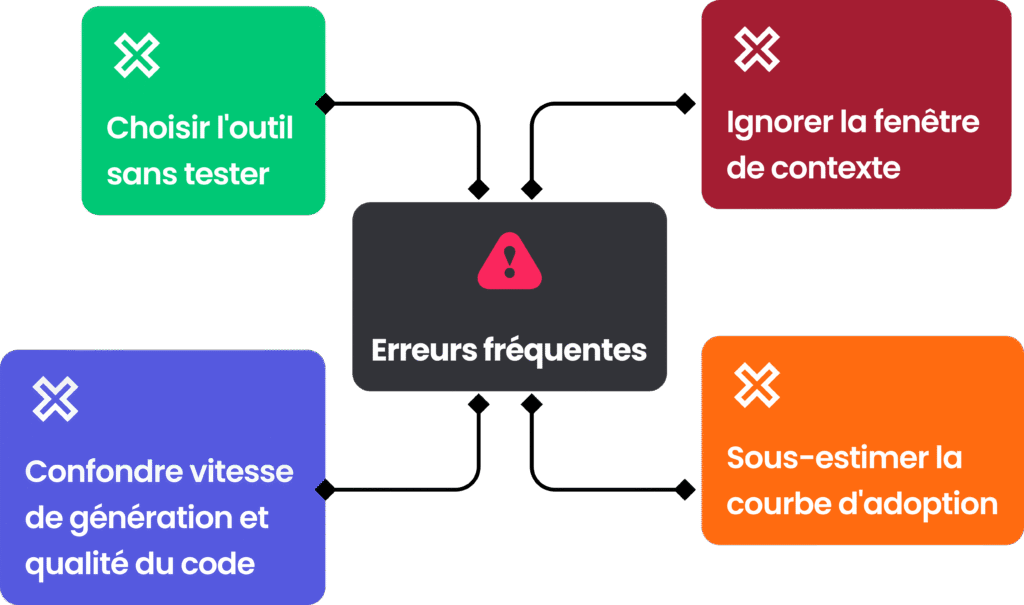
Le déploiement d’un assistant de codage en équipe fait apparaître des erreurs récurrentes, quel que soit le secteur d’activité concerné. Voici les plus fréquentes, avec les solutions concrètes pour les éviter durablement.
Choisir l'outil le plus puissant sans tester ses propres cas d'usage
Beaucoup d’équipes choisissent Claude Code uniquement parce qu’il domine les classements de benchmarks publiés. Pourtant, si la stack repose principalement sur JavaScript, Cursor peut se révéler plus efficace grâce à son intégration IDE native. Testez systématiquement l’outil sur un projet pilote réel avant tout engagement financier à long terme.
Mesurez précisément le temps gagné, la qualité du code produit et la courbe d’adoption au sein de l’équipe. Cette évaluation concrète évite d’investir dans un outil théoriquement supérieur, mais mal adapté à votre contexte réel.
Ignorer la fenêtre de contexte pour les grandes bases de code
Une équipe gérant une base de code volumineuse qui choisit un outil à fenêtre de contexte réduite s’expose à des résultats incohérents. L’outil ne voit alors qu’une fraction du projet, et génère du code qui peut casser ailleurs sans avertissement. Adaptez systématiquement la fenêtre de contexte disponible à la taille moyenne réelle de vos fichiers.
Pour une base de code volumineuse, privilégiez les outils qui offrent les plus larges fenêtres actuellement disponibles sur le marché. Ce critère devient particulièrement déterminant pour les projets legacy accumulés depuis plusieurs années sans documentation.
Confondre vitesse de génération et qualité du code livrable
Certaines équipes mesurent leur succès uniquement par le volume de lignes générées quotidiennement par l’outil. Ce raisonnement pousse à produire beaucoup de code, dont une part importante finit rejetée lors de la revue de code. Mesurez plutôt la qualité réelle, via le taux d’acceptation en revue et le nombre de bugs détectés en production.
Une équipe qui privilégie la qualité au volume observe généralement une productivité réelle supérieure sur la durée. Moins de rejet en revue signifie moins de reprise de travail, et donc un gain de temps net.
Sous-estimer la courbe d'adoption de l'équipe
Déployer un agent complexe comme Claude Code sans formation préalable conduit souvent à un abandon rapide de l’outil. Les développeurs ne savent alors pas prompter efficacement, produisent des résultats décevants et se détournent naturellement de la solution. Prévoyez systématiquement une formation dédiée, même courte, avant tout déploiement à grande échelle.
Apprendre à fournir un contexte clair, des exemples précis et des contraintes explicites change radicalement les résultats obtenus. Une IA pour coder amplifie les compétences existantes d’une équipe déjà formée, elle ralentit une équipe livrée sans accompagnement.
Besoin d'un accompagnement pour choisir et déployer votre IA de codage ?
Ethanolle accompagne les équipes techniques françaises dans le choix, la configuration et l’adoption de ces outils.
IA pour coder en entreprise : cas d'usage concrets
Voici comment les équipes techniques utilisent concrètement une IA pour coder dans un contexte de production réel. Ces exemples restent illustratifs et doivent être adaptés à votre contexte spécifique avant toute généralisation.
Automatisation des revues de code et des tests unitaires
Une équipe technique peut déléguer à Claude Code la génération d’une large part de ses tests unitaires quotidiens. Le développeur conserve alors le rôle de relecture et de validation finale, plutôt que celui de rédaction complète. Ce fonctionnement libère un temps significatif, généralement réinvesti dans des tâches à plus forte valeur ajoutée.
Refactoring de grandes bases de code legacy
Le refactoring d’une base de code ancienne, sans documentation ni couverture de tests suffisante, représente historiquement un chantier long et risqué. Un agent autonome comme Claude Code peut lire l’ensemble du projet, générer des tests puis refactoriser progressivement, en itérant sur les résultats obtenus. Cette approche réduit fortement le délai habituellement nécessaire à ce type de chantier technique complexe.
Agents autonomes pour tâches longue durée
Des équipes déploient désormais Claude Code combiné au protocole MCP pour automatiser une partie de leurs déploiements techniques répétitifs. L’agent gère alors une large part du processus, sous supervision humaine limitée, mais toujours présente. Ce type de déploiement reste un investissement stratégique, davantage qu’un simple calcul de retour sur investissement immédiat.
FAQ – IA pour coder
Quelle est la meilleure IA pour coder en 2026 ?
Le meilleur choix dépend directement de votre profil professionnel et de votre stack technique existante. Claude Code domine sur le raisonnement complexe et l’autonomie agentique, Cursor sur l’intégration IDE, Copilot sur les équipes GitHub.
Claude est-il meilleur que ChatGPT pour coder ?
Sur les tâches complexes, Claude Opus 5 devance nettement GPT-5.5 selon les derniers benchmarks publiés par Anthropic et OpenAI. Pour l’autocomplétion quotidienne simple, l’écart entre les deux modèles reste globalement mineur et peu perceptible.
Peut-on coder gratuitement avec une IA ?
Oui, la majorité des outils proposent un plan gratuit, mais avec des limites de requêtes et de contexte. Testez plusieurs outils gratuitement avant d’investir dans l’abonnement le plus adapté à votre usage réel.
GitHub Copilot ou Cursor : lequel choisir ?
Copilot convient davantage aux équipes déjà structurées sur GitHub, tandis que Cursor séduit les développeurs solo. Testez les deux options sur un projet réel avant de trancher définitivement entre ces deux solutions.
Une IA peut-elle remplacer un développeur ?
Non, une IA de codage augmente la productivité sans remplacer le jugement technique d’un développeur expérimenté. Un bon développeur accompagné par une IA reste nettement plus productif qu’un développeur qui travaille seul.
Comment utiliser Claude Code en entreprise ?
Déployez Claude Enterprise, configurez le protocole MCP pour un accès sécurisé à votre base de code. Formez ensuite l’équipe au prompting efficace, puis mesurez régulièrement le retour sur investissement obtenu.
- Claude Science : l’atelier IA d’Anthropic pour accélérer la recherche
- IA responsable : ce que les entreprises doivent vraiment mettre en place
- L’agence IA pour automatiser et transformer votre entreprise
- Claude Opus vs Sonnet : ce que les benchmarks ne disent pas sur le bon choix
- CRM IA : ce que l’intelligence artificielle change vraiment dans votre gestion client
Rejoignez plus de 180 000 clients
qui font confiance à monday.com


Expert en intégration monday
Cofondateur de l’agence Ethanolle, Léo Darmon dirige les déploiements IA et monday.com chez Ethanolle, agence partenaire spécialisée dans l’industrialisation des plateformes collaboratives en entreprise. Il accompagne des DSI et CTO d’ETI françaises sur la sélection, le déploiement et la gouvernance d’outils IA depuis 2023.