Déployez Claude AI en entreprise
Structurez vos usages pour sécuriser vos données et gagner en efficacité
Un développeur sur trois a déjà vu un agent IA valider silencieusement du code défaillant, selon les propres évaluations internes rendues publiques par Anthropic. Cette statistique explique pourquoi Claude Opus 4.8 a suscité autant d’attention auprès des équipes techniques françaises. Les DSI et responsables produit cherchent un modèle capable de tenir un raisonnement long sans dérailler, plutôt qu’une simple liste de fonctionnalités marketing.
Ce guide décortique ce que change réellement Claude Opus 4.8 au quotidien, benchmarks vérifiés et cas d’usage concrets à l’appui. Notez cependant un point de contexte essentiel : Anthropic a lancé Claude Opus 5 le 24 juillet 2026. Opus 4.8 reste néanmoins une base stable, largement déployée en production, et cet article détaille aussi bien ses forces actuelles que sa place dans la gamme Claude AI après ces annonces récentes.
Qu'est-ce que Claude Opus 4.8 ?
Pour comprendre le positionnement d’Opus 4.8, il faut d’abord connaître la structure complète de la gamme Claude et les deux nouveautés qui distinguent ce modèle des versions précédentes.
La place d'Opus 4.8 dans la gamme Claude
Anthropic organise sa gamme selon trois niveaux d’intelligence, chacun répondant à un compromis différent entre vitesse, coût et profondeur de raisonnement. Claude Haiku 4.5 vise la vitesse et le traitement à fort volume, pour des tâches simples et répétitives. Claude Sonnet 5 occupe le milieu de gamme avec un excellent rapport performance/prix pour un usage quotidien.
Claude Opus 4.8, lui, cible les tâches les plus exigeantes : raisonnement complexe, workflows agentiques longs et séquences de codage multi-étapes. Cette position s’inscrit dans la stratégie plus large présentée sur la page Claude Anthropic, qui détaille l’ensemble de la gamme et sa logique de tarification. Lancé le 28 mai 2026, il constitue une étape importante dans l’évolution des modèles Opus d’Anthropic, avant l’arrivée d’Opus 5.
Les nouveautés clés d'Opus 4.8
Trois évolutions distinguent Opus 4.8 de son prédécesseur direct, Opus 4.7. Anthropic annonce une honnêteté renforcée : le modèle est environ quatre fois moins susceptible de laisser passer une faille de code sans la signaler.
La fonction Effort Control permet d’arbitrer entre profondeur de raisonnement et coût en tokens sur chaque requête. La Messages API accepte désormais des modifications en cours de tâche, ce qui autorise un ajustement des instructions sans casser la mise en cache du prompt. Ces trois piliers structurent toute la suite de cet article.
Les nouveaux modèles Anthropic sortis après Opus 4.8
Anthropic a publié quatre nouveaux modèles en moins de deux mois après le lancement d’Opus 4.8, un rythme inédit qui redéfinit la hiérarchie complète de la gamme Claude. La compréhension de ces sorties devient indispensable avant tout choix de déploiement en 2026.
Claude Fable 5 : le modèle frontier grand public

Fable 5 est sorti le 9 juin 2026, positionné dans un nouveau tier appelé Mythos, au-dessus de la gamme Opus. Son tarif atteint 10 $ par million de tokens en entrée et 50 $ en sortie, soit environ 9,20 € et 46 €, le double du tarif d’Opus 4.8. Ce modèle cible les tâches les plus exigeantes : migrations massives de bases de code, travail agentique sur plusieurs jours, et analyse visuelle avancée.
Sur le benchmark FrontierCode Diamond, Fable 5 atteint 29,3 % contre seulement 13,4 % pour Opus 4.8, un écart qui traduit un vrai saut de capacité sur les problèmes de programmation les plus difficiles. Un mécanisme de fallback automatique redirige vers Opus 4.8 toute requête touchant à des domaines sensibles comme la cybersécurité ou la biologie.
Cette accessibilité a connu une interruption notable. Anthropic a suspendu l’accès à Fable 5 et à Mythos 5 du 12 au 30 juin 2026, en conformité avec des contrôles à l’export du Département du Commerce américain. L’accès a été restauré le 1er juillet 2026, comme le confirme le communiqué officiel d’Anthropic. Toute entreprise ayant intégré Fable 5 dans un workflow critique doit garder ce précédent en tête pour anticiper une éventuelle coupure future.
Claude Mythos 5 : le modèle frontier à accès restreint

Mythos 5 partage exactement les mêmes poids que Fable 5, sorti le même jour, mais sans les garde-fous de sécurité appliqués aux domaines sensibles. Son accès reste réservé aux partenaires accrédités du Project Glasswing, à certaines agences gouvernementales et à des chercheurs biomédicaux vérifiés. Aucune entreprise standard ni aucun utilisateur grand public ne peut y accéder aujourd’hui. Cette restriction explique pourquoi Fable 5, sa version publique bridée, reste la seule option pertinente pour la quasi-totalité des cas d’usage B2B.
Claude Sonnet 5 : la performance Opus à moitié prix

Sorti le 30 juin 2026, Sonnet 5 propose un tarif introductif de 2 $ par million de tokens en entrée et 10 $ en sortie jusqu’au 31 août 2026, soit environ 1,84 € et 9,20 €. Passé cette date, le tarif standard remonte à 3 $/15 $. Sonnet 5 atteint 63,2 % sur SWE-bench Pro, un score qui se rapproche sensiblement des 69,2 % d’Opus 4.8 pour une fraction du coût. Il devient automatiquement le modèle par défaut sur les plans Free et Pro depuis le 1er juillet 2026, tandis qu’Opus 5, sorti après lui, reste sélectionnable manuellement sur Pro pour les tâches les plus exigeantes.
Claude Opus 5 : l'intelligence frontier au prix d'Opus 4.8

Anthropic a lancé Opus 5 le 24 juillet 2026, au même tarif qu’Opus 4.8, soit 5 $/25 $ par million de tokens en entrée et sortie, environ 4,60 € et 23 €. Sur Frontier-Bench v0.1, Opus 5 atteint 43,3 %, plus du double du score d’Opus 4.8 sur cette même évaluation. Sur ARC-AGI-3, il obtient 30,2 %, un score environ trois fois supérieur au modèle suivant sur ce classement. Anthropic indique aussi qu’Opus 5 dépasse Fable 5 sur OSWorld 2.0 pour un tiers de son coût. Ce modèle devient le nouveau défaut sur Claude Max dès son lancement, une bascule confirmée par l’annonce officielle Anthropic.
Quel modèle choisir selon votre profil ?
Le tableau suivant synthétise les cinq profils d’entreprise les plus fréquents observés par nos équipes lors des déploiements clients.
| Profil | Modèle | Prix input | Points forts | Cas d'usage |
|---|---|---|---|---|
|
Équipe coût-sensible |
Sonnet 5 |
1,84 € / M |
Agentique, polyvalent |
Automatisation quotidienne |
|
Dev / DSI standard |
Opus 4.8 |
4,60 € / M |
Stable, fiable, déjà déployé |
Workflows longs établis |
|
Dev / DSI exigeant |
Opus 5 |
4,60 € / M |
Frontier au prix Opus |
Nouveaux projets complexes |
|
Recherche / frontier |
Fable 5 |
9,20 € / M |
Meilleurs benchmarks publics |
Migrations massives, science |
|
Cybersécurité accréditée |
Mythos 5 |
9,20 € / M |
Capacités non bridées |
Projets gouvernementaux, biomédicaux |
Ce panorama montre pourquoi la majorité des entreprises françaises interrogées lors de nos audits gardent Opus 4.8 en production plutôt que de migrer immédiatement.
Vous ne savez pas quel modèle Claude choisir pour votre organisation ?
Opus 4.8, Opus 5, Fable 5, Sonnet 5 : chaque modèle répond à des besoins différents. Nos experts analysent vos cas d’usage et vous recommandent la configuration optimale.
Performances de Claude Opus 4.8 : les benchmarks qui comptent
Anthropic publie de nombreux benchmarks à chaque lancement, mais tous ne mesurent pas des situations professionnelles réelles. Voici les trois résultats qui traduisent le mieux un usage d’entreprise concret.
Online-Mind2Web : 84 % sur les tâches browser-agent
Ce benchmark évalue la capacité d’un modèle à naviguer un navigateur web de façon autonome, en cliquant, en remplissant des formulaires et en enchaînant plusieurs pages. Opus 4.8 y atteint 84 %, un score qu’Anthropic qualifie de « meilleur modèle de navigation et d’usage d’ordinateur jamais testé » par ses équipes. Ce résultat dépasse aussi bien Opus 4.7 que GPT-5.5 sur la même évaluation.
Legal Agent Benchmark : premier modèle à franchir 10 % all-pass
Sur ce benchmark exigeant, un modèle ne réussit une tâche que si l’intégralité de ses sous-étapes est validée. Opus 4.8 devient le premier modèle à dépasser 10 % sur ce standard « all-pass », un résultat directement pertinent pour les équipes juridiques qui délèguent des analyses contractuelles.
OSWorld-Verified : 83,4 % en usage autonome d'ordinateur
OSWorld-Verified teste la capacité d’un modèle à manipuler un ordinateur réel, gestion de fichiers et éditeurs bureautiques compris. Opus 4.8 obtient 83,4 %, contre 78,7 % pour GPT-5.5, un écart de près de cinq points qui confirme sa solidité sur les tâches d’agent bureautique. Ce résultat conditionne directement la fiabilité des Dynamic Workflows évoqués plus bas.
Claude Opus 4.8 vs GPT-5.5 : comparatif tranché
| Benchmark | Opus 4.8 | GPT-5.5 | Avantage | Idéal pour |
|---|---|---|---|---|
|
Online-Mind2Web |
84 % |
Score inférieur |
Opus 4.8 |
Agents navigateur |
|
Legal Agent Benchmark |
1er à franchir 10 % |
Score inférieur |
Opus 4.8 |
Analyse juridique |
|
SWE-bench Pro |
69,2 % |
58,6 % |
Opus 4.8 |
Ingénierie logicielle |
|
OSWorld-Verified |
83,4 % |
78,7 % |
Opus 4.8 |
Usage autonome d’ordinateur |
|
Terminal-Bench 2.1 |
74,6 % |
78,2 à 83,4 % |
GPT-5.5 |
CLI natif Codex |
Où GPT-5.5 garde l'avantage ?
Contrairement à une lecture trop favorable d’Opus 4.8, GPT-5.5 conserve un avantage réel sur deux terrains précis. Sur Terminal-Bench 2.1, mesuré avec le harnais natif Codex CLI d’OpenAI, GPT-5.5 devance Opus 4.8. Sur ARC-AGI-2, un test de raisonnement visuel inédit, l’écart atteint près de treize points en faveur de GPT-5.5. Notre comparatif dédié Claude vs ChatGPT détaille l’ensemble des écarts entre les deux modèles, au-delà des seuls benchmarks cités ici.
Et face à Gemini 3.1 Pro ?
Un troisième acteur mérite sa place dans ce comparatif. Sur SWE-bench Pro, Opus 4.8 devance Gemini 3.1 Pro d’environ quinze points, un écart stable selon plusieurs analyses indépendantes. Sur OSWorld-Verified, Gemini 3.1 Pro obtient 76,2 %, un score inférieur aux 83,4 % d’Opus 4.8, mais proche de celui de GPT-5.5. Pour les entreprises déjà ancrées dans l’écosystème Google Workspace, notre article Claude vs Gemini approfondit ce comparatif avec des critères propres à un contexte Workspace.
Verdict par profil : pour du code agentique complexe, Opus 4.8 reste le choix le plus fiable. Pour des pipelines CLI natifs sous Codex, GPT-5.5 garde un avantage réel. Pour un DSI déjà équipé Google, Gemini 3.1 Pro mérite un test comparatif avant décision finale.
Fonctionnalités de Claude Opus 4.8
Trois fonctionnalités majeures distinguent Opus 4.8 de ses prédécesseurs. Voici ce qu’elles changent concrètement dans un déploiement d’entreprise.
Effort Control : choisir entre vitesse et profondeur
Le paramètre effort propose quatre niveaux : High (par défaut sur toutes les surfaces), Extra, xhigh et Max. Chaque palier arbitre entre exhaustivité de la réponse et consommation de tokens. Utiliser « Extra » ou « xhigh » convient aux analyses complexes qui justifient un coût plus élevé, tandis que « Max » reste réservé aux agents totalement autonomes sur des tâches critiques. Ce réglage impacte directement les limites de débit facturées par l’API.
Dynamic Workflows : Claude Code à l'échelle industrielle
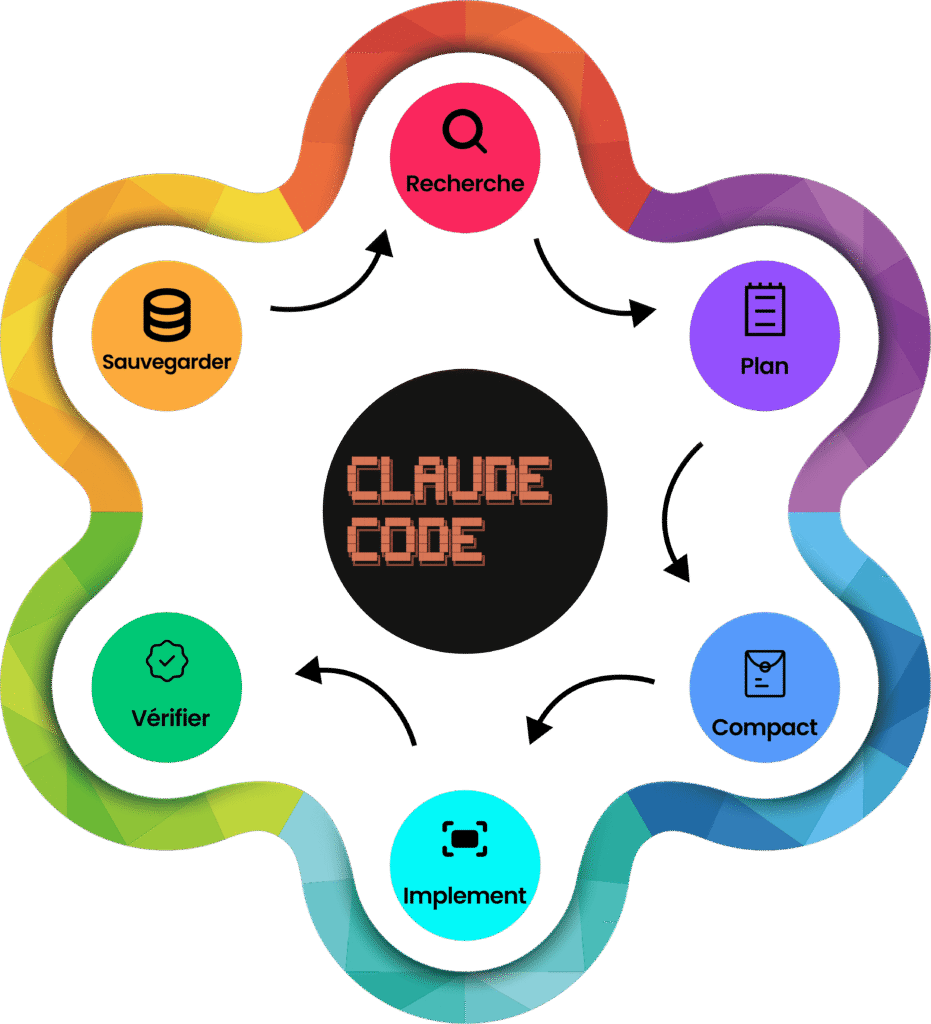
Cette fonctionnalité permet à Claude Code de planifier une tâche complexe, puis de lancer des centaines de sous-agents en parallèle au sein d’une même session, avant de vérifier les résultats et de rendre compte à l’utilisateur. Anthropic cite l’exemple d’une migration de base de code portant sur des centaines de milliers de lignes, menée du lancement jusqu’au merge final.
Cette fonctionnalité reste, au moment de la rédaction, documentée comme un aperçu de recherche sur certaines surfaces : vérifiez son statut exact sur la documentation officielle avant de vous engager sur un déploiement à grande échelle. Elle est réservée aux plans Enterprise, Team et Max.
Messages API : mise à jour des instructions en cours de tâche
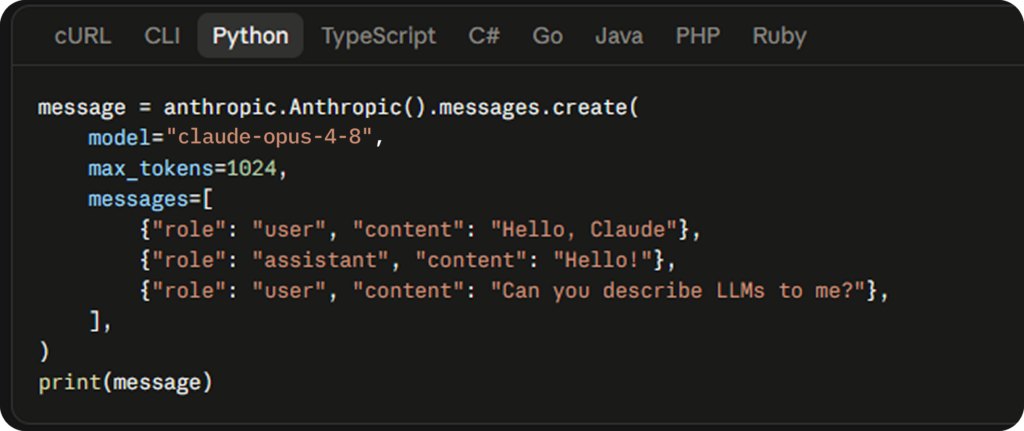
La Messages API accepte désormais des entrées système ajoutées directement dans le tableau des messages, en cours de conversation. Cette évolution permet de modifier les permissions ou les budgets de tokens sans casser la mise en cache du prompt Claude ni interrompre une session active. Pour les équipes qui pilotent des agents longue durée, ce changement réduit sensiblement la complexité d’orchestration.
Vous souhaitez activer ces fonctionnalités dans vos équipes ?
Nous configurons Claude Opus 4.8 selon vos cas d’usage : choix du niveau d’effort, paramétrage API, mise en production.
Comment utiliser Claude Opus 4.8 ?
Accéder à Opus 4.8 ne demande aucune configuration complexe. Voici les trois points d’entrée selon votre profil technique.
Via claude.ai : prise en main immédiate
Le sélecteur de modèle, situé dans l’interface de conversation, permet de choisir Opus 4.8 directement parmi les options disponibles sur votre plan. L’activation du paramètre Effort se fait depuis le même menu, sans configuration technique. Cette voie convient aux plans Pro, Max, Team et Enterprise, non au plan Free. Les utilisateurs du plan gratuit peuvent consulter notre guide Claude gratuit pour connaître les modèles disponibles sans abonnement.
Via l'API Claude : l'identifiant claude-opus-4-8
Les développeurs appellent Opus 4.8 via l’identifiant API « claude-opus-4-8 », disponible sur l’API Claude, Amazon Bedrock, Google Vertex AI et Microsoft Foundry. Le mode rapide, facturé $10/$50 par million de tokens, promet une vitesse 2,5 fois supérieure au mode standard, mais reste documenté comme un aperçu de recherche : vérifiez sa disponibilité effective avant intégration en production.
Via Claude Code : Dynamic Workflows et agents parallèles
L’installation de Claude Code active nativement Opus 4.8 comme modèle sélectionnable, à condition de disposer d’un plan Enterprise, Team ou Max pour profiter des Dynamic Workflows. Une mise à jour vers la dernière version du client reste nécessaire pour accéder à cette fonctionnalité de sous-agents parallèles.
L'honnêteté comme fonctionnalité : ce que ça change
Anthropic met en avant une amélioration mesurable de l’honnêteté du modèle, un axe rarement traité avec autant de rigueur par la concurrence.
Ce que mesure vraiment le taux de failles non signalées
Opus 4.8 se révèle environ quatre fois moins susceptible que son prédécesseur de laisser une faille de code passer sans commentaire. Concrètement, quand le modèle détecte une incohérence ou un risque dans une réponse générée, il le signale désormais plutôt que de le dissimuler dans un résultat qui paraît complet. Les retours terrain d’Ethanolle sur des workflows longs confirment cette tendance : le modèle interrompt plus souvent une tâche pour demander une clarification, plutôt que de produire un résultat plausible, mais erroné.
Limites persistantes malgré les progrès d'honnêteté
Ce progrès ne rend pas le modèle infaillible pour autant. Sur des tâches ambiguës ou faiblement documentées, un risque d’hallucination subsiste, comme le rappelle d’ailleurs l’article dédié aux agents Claude. Une supervision humaine reste recommandée pour toute décision à fort enjeu métier, quel que soit le niveau d’Effort Control sélectionné.
Tarifs Claude Opus 4.8 : même prix, meilleures performances

Anthropic n’a pas augmenté les prix avec Opus 4.8 par rapport à Opus 4.7. Voici ce que cela représente concrètement selon votre usage, converti en euros au taux approximatif du mois de rédaction.
| Mode | Prix input (M tokens) | Prix output (M tokens) | Vitesse | Idéal pour |
|---|---|---|---|---|
|
Standard |
4,60 € |
23 € |
Référence |
Tâches asynchrones |
|
Fast mode (aperçu de recherche) |
9,20 € |
46 € |
2,5x plus rapide |
Temps réel, agents |
Fast mode : toujours en aperçu de recherche
Au moment de la rédaction, la documentation officielle Claude qualifie encore le Fast mode d’aperçu de recherche sur l’API. Cela signifie une disponibilité potentiellement limitée ou évolutive : vérifiez ce statut sur la documentation Anthropic avant tout engagement contractuel avec un client final.
Ce que coûte réellement un déploiement à l'échelle
Au-delà du tarif affiché, trois leviers influencent la facture réelle. La mise en cache des prompts système réduit fortement le coût des contextes répétés. Le regroupement des tâches non urgentes vers l’API Batch réduit le prix de moitié. La limitation du paramètre « max_tokens » plafonne le pire scénario de facturation par appel, un réglage trop souvent négligé lors des premiers déploiements.
Verdict par profil : une PME au budget serré privilégiera le mode standard avec un Effort modéré. Un développeur solo optimisera via le cache et le mode Batch. Une entreprise avec des besoins temps réel justifiera le surcoût du Fast mode une fois sa disponibilité confirmée.
Claude Opus 4.8 en entreprise : niveau d'effort et cas d'usage
Opus 4.8 reste conçu pour les workflows longs et les équipes distribuées. Voici comment le déployer efficacement en environnement professionnel.
Choisir le bon niveau d'effort selon le cas métier

Le niveau High, activé par défaut, convient à la majorité des tâches courantes sans réglage supplémentaire. Le niveau Extra se justifie pour des analyses complexes qui tolèrent un coût plus élevé en échange d’une meilleure exhaustivité. Le niveau Max reste réservé aux agents totalement autonomes qui exécutent des tâches critiques sans supervision continue.
Connecter Opus 4.8 à vos workflows monday CRM
L’intégration d’Opus 4.8 dans monday CRM permet d’automatiser la qualification de leads entrants et la rédaction de propositions commerciales personnalisées à partir des données du pipeline de vente. Cette approche s’appuie sur les agents IA monday déjà disponibles nativement sur la plateforme, sans développement custom nécessaire pour la majorité des cas d’usage standards.
Erreurs fréquentes observées lors du déploiement
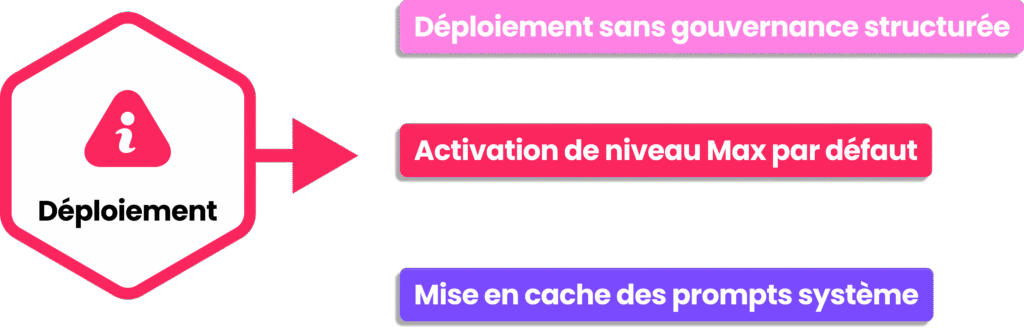
Le retour terrain d’Ethanolle révèle un schéma récurrent chez les entreprises qui déploient Opus 4.8 sans gouvernance structurée. Beaucoup d’équipes activent le niveau Max par défaut sur toutes les tâches, ce qui gonfle inutilement la facture sans gain de qualité perceptible. D’autres omettent totalement la mise en cache des prompts système, ce qui multiplie le coût des sessions longues répétées quotidiennement.
Prêt à déployer Claude Opus 4.8 dans votre organisation ?
Nos experts vous accompagnent de la sélection du niveau d’effort adapté à vos cas métier jusqu’à l’intégration complète dans vos workflows.
La matrice de déploiement Opus 4.8 by Ethanolle
Aucun comparatif public ne propose aujourd’hui d’outil de décision structuré pour choisir le bon mode Opus 4.8 selon un contexte métier précis. Cette section propose une méthode propriétaire développée par Ethanolle à partir de ses audits clients.
Une matrice à trois critères pour choisir le bon mode
La méthode croise trois critères simples : le niveau d’effort requis par la tâche, le budget mensuel alloué au poste IA, et la criticité métier de la décision finale prise à partir de la réponse du modèle. Une tâche à faible criticité et fort volume oriente naturellement vers Sonnet 5 ou un effort High modéré. Une tâche à forte criticité et faible volume justifie un effort Max sur Opus 4.8, quel qu’en soit le coût unitaire.
Trois profils types et leur mode recommandé
Une PME du secteur immobilier, avec un volume élevé de qualification de leads, tire le meilleur rapport coût-efficacité d’un effort High sur Sonnet 5. Un cabinet juridique qui traite des analyses contractuelles complexes justifie un effort Extra sur Opus 4.8, compte tenu du score obtenu sur le Legal Agent Benchmark. Une équipe R&D travaillant sur une migration de base de code à grande échelle gagne à activer les Dynamic Workflows d’Opus 4.8 en effort Max, malgré son statut encore expérimental sur certaines surfaces.
FAQ – Claude Opus 4.8
Quelle différence entre Claude Opus 4.8 et Opus 4.7 ?
Opus 4.8 conserve exactement le même tarif qu’Opus 4.7, mais améliore significativement l’honnêteté du modèle, avec un taux de failles de code non signalées environ quatre fois plus faible. Il introduit aussi l’Effort Control, les Dynamic Workflows et une Messages API capable d’accepter des modifications en cours de tâche. Ces trois nouveautés justifient une mise à niveau immédiate pour toute équipe déjà sur Opus 4.7, sans coût supplémentaire à prévoir.
Claude Opus 4.8 est-il disponible gratuitement ?
Non, Opus 4.8 n’est pas accessible sur le plan Free de claude.ai. Au moment de la rédaction, les utilisateurs gratuits disposent de Sonnet 5 comme modèle par défaut. Opus 4.8 reste réservé aux plans Pro, Max, Team et Enterprise, ainsi qu’à un accès facturé via l’API Claude.
Comment accéder à Claude Opus 4.8 via l'API ?
L’identifiant API « claude-opus-4-8 » permet d’appeler ce modèle directement depuis l’API Claude, Amazon Bedrock, Google Vertex AI ou Microsoft Foundry. Une clé API valide et un compte développeur Anthropic actif suffisent pour démarrer, sans configuration technique complexe additionnelle requise.
Qu'est-ce que Dynamic Workflows dans Claude Code ?
Cette fonctionnalité permet à Claude Code de planifier une tâche complexe puis de lancer des centaines de sous-agents en parallèle au sein d’une même session de travail. Elle vise les migrations de code à grande échelle et reste réservée aux plans Enterprise, Team et Max, avec un statut à reconfirmer selon la surface utilisée.
Claude Opus 4.8 est-il meilleur que GPT-5.5 ?
Cela dépend entièrement du cas d’usage visé par votre équipe. Opus 4.8 devance GPT-5.5 sur le code agentique complexe et l’usage autonome d’ordinateur, tandis que GPT-5.5 garde l’avantage sur Terminal-Bench 2.1 sous son harnais natif Codex CLI et sur le raisonnement visuel ARC-AGI-2.
Quel plan choisir pour utiliser Opus 4.8 ?
Un plan Pro convient à un usage individuel régulier avec un budget maîtrisé chaque mois. Un plan Max ou Team s’impose pour une équipe qui a besoin des Dynamic Workflows et d’une collaboration multi-utilisateurs. Un plan Claude Enterprise reste recommandé pour toute organisation nécessitant une gouvernance centralisée et un support dédié.
Qu'est-ce que l'Effort Control dans Claude Opus 4.8 ?
Ce paramètre permet d’arbitrer entre la profondeur de raisonnement du modèle et sa consommation de tokens sur chaque requête individuelle. Quatre niveaux existent : High par défaut, Extra, xhigh et Max, chacun adapté à un degré de complexité et de criticité métier différent.
- Claude Science : l’atelier IA d’Anthropic pour accélérer la recherche
- IA responsable : ce que les entreprises doivent vraiment mettre en place
- L’agence IA pour automatiser et transformer votre entreprise
- Claude Opus vs Sonnet : ce que les benchmarks ne disent pas sur le bon choix
- CRM IA : ce que l’intelligence artificielle change vraiment dans votre gestion client
Rejoignez plus de 180 000 clients
qui font confiance à monday.com


Expert en intégration monday
Cofondateur de l’agence Ethanolle, Léo Darmon dirige les déploiements IA et monday.com chez Ethanolle, agence partenaire spécialisée dans l’industrialisation des plateformes collaboratives en entreprise. Il accompagne des DSI et CTO d’ETI françaises sur la sélection, le déploiement et la gouvernance d’outils IA depuis 2023.