Déployez Claude AI en entreprise
Structurez vos usages pour sécuriser vos données et gagner en efficacité
En bref : Claude Sonnet 5 convient à la majorité des usages professionnels grâce à son rapport qualité prix. Claude Opus 5 se justifie sur le raisonnement complexe, les agents longue durée et les projets d’entreprise à fort enjeu. Le choix dépend surtout de votre tâche, pas seulement du numéro de version.
Choisir le mauvais modèle Claude coûte cher, dans un sens comme dans l’autre. Une équipe qui déploie Opus pour reformuler trois lignes de texte gaspille son budget sans gagner en qualité perceptible. À l’inverse, confier un audit de sécurité complexe à Sonnet peut générer des réponses incomplètes sur les tâches les plus complexes. Depuis fin juin 2026, Anthropic a publié coup sur coup deux nouvelles générations de modèles, ce qui a rebattu les cartes du match Claude Opus vs Sonnet.
Notre agence accompagne des équipes françaises dans leur déploiement de Claude au quotidien, en tant que partenaire certifié Anthropic. Nous avons observé sur le terrain les écarts réels entre les deux modèles, au-delà des chiffres marketing habituels. Ce guide traite douze angles complémentaires, du prix jusqu’aux erreurs de configuration les plus fréquentes. Vous repartirez avec une grille de décision applicable dès aujourd’hui, quelle que soit la taille de votre équipe.
Quelle est la différence entre Claude Opus et Sonnet ?
Opus et Sonnet reposent sur la même architecture de raisonnement hybride, mais ils ciblent différents usages. Sonnet privilégie la rapidité et le volume, tandis qu’Opus vise la profondeur d’analyse sur les tâches les plus complexes. Cette section détaille les écarts concrets entre les deux modèles.
Deux philosophies de conception
Claude Sonnet 5 a été conçu pour offrir, à moindre coût, des performances qui exigeaient auparavant un modèle plus lourd. Anthropic le positionne comme le modèle du quotidien, pensé pour les agents en temps réel et les tâches à fort volume.
Claude Opus 5, de son côté, cible les charges de travail les plus lourdes. Il est pensé pour les agents autonomes qui tournent sur de longues durées, avec un besoin élevé de fiabilité et de jugement.
Cette différence de philosophie se retrouve jusque dans les réglages disponibles pour les développeurs. Les deux modèles proposent des niveaux d’effort ajustables, mais Opus atteint son plafond de performance à un effort plus élevé, réservé aux tâches à forte valeur.
Ce qu'Opus fait mieux
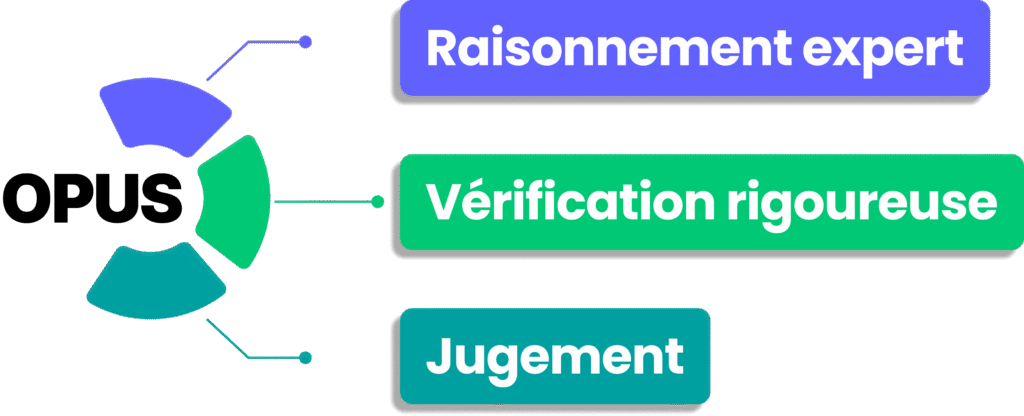
Opus excelle sur le raisonnement expert et les tâches qui demandent une vérification rigoureuse à chaque étape. Plusieurs clients d’Anthropic rapportent des gains marqués sur ce terrain précis.
Chez Box, Opus 5 dépasse son prédécesseur Opus 4.8 de 8 % en moyenne, avec une progression de 17 % sur les tâches de due diligence. Chez Lovable, l’écart grimpe à 22 % sur les tâches d’ingénierie logicielle les plus complexes, par rapport à la génération précédente. Ces deux exemples concernent de longues tâches, à plusieurs étapes, où une erreur intermédiaire se propage facilement jusqu’au résultat final.
Opus se distingue aussi sur le jugement, un critère difficile à mesurer par un score unique. Un client spécialisé en revue de code rapporte qu’Opus vérifie ses propres branches, contrôle les modèles de pull request en usage, et anticipe les conséquences d’un changement avant de le proposer.
Ce que Sonnet fait mieux
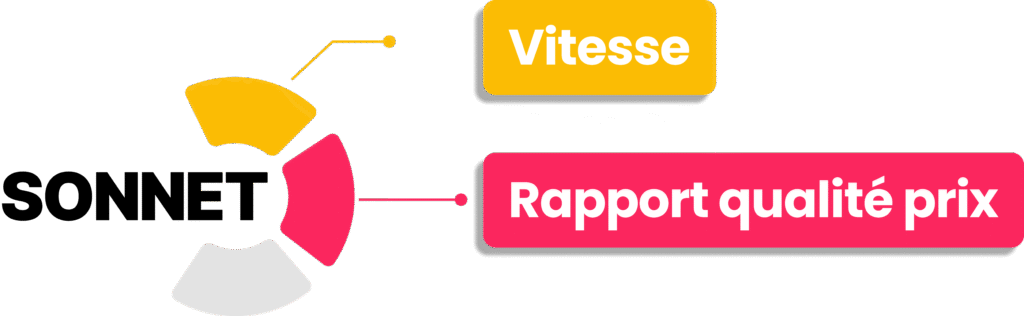
Sonnet conserve un net avantage sur la latence et le rapport qualité prix. Ce point en fait le choix par défaut pour la production à grande échelle. Il reste aussi la première option pour le codage quotidien et les tâches à haut volume.
Selon Anthropic, Sonnet 5 apporte une performance auparavant réservée aux modèles plus lourds de la gamme. Le modèle garde malgré tout la vitesse et le tarif propres à la famille Sonnet. C’est un argument fort pour les équipes qui traitent un grand nombre de requêtes chaque jour.
Un client spécialisé en agents financiers rapporte d’ailleurs que Sonnet 5 dépasse le niveau de frontière actuel sur plusieurs tâches complexes, tout en gardant un temps de réponse rapide et un coût contenu. C’est précisément ce croisement entre qualité et rapidité qui explique la popularité du modèle en production.
Ce que les deux modèles partagent
Opus et Sonnet partagent une fenêtre de contexte qui atteint jusqu’à 1 million de tokens en configuration étendue. Les deux modèles offrent aussi un accès identique via l’API Claude. Ils bénéficient enfin du même cadre de conformité chez Anthropic, un point détaillé plus loin dans cet article.
Pour approfondir les caractéristiques propres à chaque modèle, consultez nos pages dédiées à Claude Sonnet et à Claude Opus 4.8. Cette dernière page couvre la génération qui a précédé Opus 5.
Quels sont les benchmarks d'Opus et Sonnet ?
Les scores publics donnent une première indication, mais ils ne racontent pas toute l’histoire. Cette section croise les données officielles d’Anthropic avec des retours d’usage réels en production.
Le tableau ci-dessous reprend les informations disponibles sur les pages officielles Claude Opus et Claude Sonnet.
| Mécanisme | Fonction principale | Mode d'activation | Portée |
|---|---|---|---|
|
Claude Skills |
Procédures et instructions métier |
Dynamique, selon la tâche |
Ponctuelle |
|
Projects |
Contexte et connaissances statiques |
Permanente sur le projet |
Toute la conversation |
|
MCP |
Connexion à des services externes |
Sur appel de l’outil connecté |
Selon le connecteur activé |
|
Subagents |
Orchestration de sous-tâches |
Déclenchée par le workflow |
Le temps de la sous-tâche |
Les benchmarks qui comptent pour un déploiement professionnel
Trois familles de tests reviennent dans presque toutes les comparaisons de modèles Claude, et chacune mesure une capacité bien distincte. Comprendre ce qu’elles évaluent réellement évite de sur-interpréter un simple score global.
SWE-bench Verified mesure la capacité d’un modèle à corriger de vrais tickets GitHub, sur des projets open source réels et vérifiés par des humains. Un score élevé indique une bonne aptitude à comprendre une base de code existante, puis à produire un correctif fonctionnel sans casser le reste du projet.
GPQA Diamond évalue un raisonnement scientifique de niveau doctorat, sur des questions de biologie, chimie et physique conçues pour être difficiles même pour des experts humains. Ce test reflète surtout la profondeur de raisonnement du modèle, un critère pertinent pour la recherche ou l’analyse stratégique.
Terminal-bench teste la capacité d’un modèle à utiliser un terminal en ligne de commande pour accomplir des tâches concrètes, comme un ingénieur système le ferait. Ce test se rapproche davantage d’un usage agentique réel, où le modèle enchaîne plusieurs outils sans supervision constante.
Ce que les benchmarks mesurent, et ce qu'ils ne mesurent pas
Les benchmarks publics évaluent des tâches standardisées, souvent éloignées de vos cas d’usage réels en entreprise. Un score élevé sur un test de codage générique ne garantit pas une bonne performance sur votre codebase spécifique, avec ses propres conventions et son historique.
Les retours clients cités plus haut, comme ceux de Box ou de Lovable, mesurent des gains en conditions réelles de production. Ils restent plus représentatifs pour évaluer l’intérêt d’Opus sur vos propres flux de travail, puisqu’ils intègrent la complexité réelle d’un environnement métier
Verdict : quand l'écart est significatif, quand il est négligeable ?
L’écart entre Opus et Sonnet devient significatif sur les tâches longues et multi-étapes, où une erreur en cours de route coûte cher à corriger. Sur une tâche courte et bien cadrée, l’écart de qualité perçue reste souvent négligeable.
Sonnet est-il plus rapide qu'Opus ?
La vitesse reste un critère décisif pour les usages en temps réel, comme les agents conversationnels ou les workflows interactifs. Cette section détaille l’impact concret de la latence sur vos choix d’architecture.
Latence comparée
Anthropic positionne explicitement Sonnet 5 comme son modèle pensé pour les agents en temps réel, avec une vitesse supérieure à celle d’Opus. Plusieurs clients rapportent des gains de rapidité marqués, y compris face à l’ancienne génération Opus.
Chez Sourcegraph, Opus 5 tourne avec environ un septième des tokens de raisonnement et moins de la moitié de la latence d’Opus 4.8. Cela montre que même au sein de la gamme Opus, l’efficacité progresse fortement d’une génération à l’autre.
Impact sur les workflows
Un chatbot client attend une réponse en une ou deux secondes pour rester fluide, ce qui favorise Sonnet. Un pipeline d’analyse documentaire nocturne peut, à l’inverse, tolérer un temps de traitement plus long en échange d’une meilleure qualité.
Cette distinction structure directement le choix d’architecture technique. Un système synchrone, où l’utilisateur attend la réponse à l’écran, tolère mal la latence supplémentaire d’Opus. Un système asynchrone, qui traite des lots de documents en tâche de fond, absorbe cette latence sans conséquence visible pour l’utilisateur final.
Quand la vitesse prime sur la qualité
La vitesse doit primer dès que l’expérience utilisateur repose sur une interaction fluide, comme le support client en direct. Dans ce cas, Sonnet reste le choix par défaut, sauf besoin ponctuel de raisonnement approfondi.
Vous déployez Claude en entreprise ?
Un appel de 20 minutes suffit pour identifier le bon modèle selon votre stack et vos contraintes RGPD.
Quel est le prix d'Opus et Sonnet ?
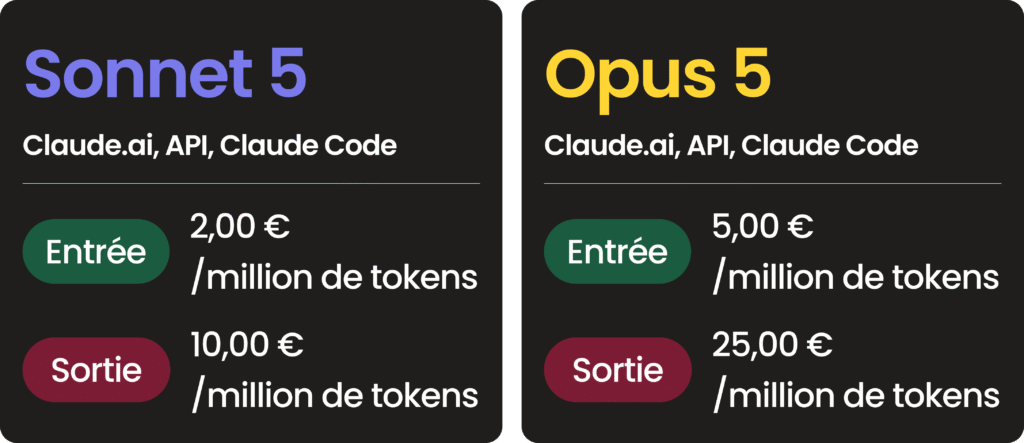
Le prix conditionne directement le choix du modèle à grande échelle, surtout sur les workflows à fort volume. Cette section détaille les tarifs actuels et leur impact réel sur votre budget. Les tarifs ci-dessous reprennent les prix officiels publiés sur claude.com/pricing.
| Mécanisme | Fonction principale | Mode d'activation | Portée |
|---|---|---|---|
|
Claude Skills |
Procédures et instructions métier |
Dynamique, selon la tâche |
Ponctuelle |
|
Projects |
Contexte et connaissances statiques |
Permanente sur le projet |
Toute la conversation |
|
MCP |
Connexion à des services externes |
Sur appel de l’outil connecté |
Selon le connecteur activé |
|
Subagents |
Orchestration de sous-tâches |
Déclenchée par le workflow |
Le temps de la sous-tâche |
Trois scénarios de coûts chiffrés
Pour un debug rapide sur une fonction isolée, Sonnet suffit largement et coûte une fraction du prix d’Opus pour un résultat équivalent. Sur ce type de tâche, l’écart de qualité perçu reste minime, ce qui rend le surcoût d’Opus difficile à justifier.
Pour un refactor moyen qui touche plusieurs fichiers liés, Sonnet reste souvent pertinent, avec une bascule vers Opus si les premiers résultats manquent de rigueur. C’est un point de bascule fréquent chez nos clients, généralement identifié après une ou deux itérations infructueuses.
Pour une architecture complexe qui implique des dizaines de fichiers interdépendants, Opus justifie son surcoût par une meilleure cohérence sur la durée. Le risque d’erreur coûteuse en aval diminue nettement avec ce choix, surtout sur un projet qui s’étale sur plusieurs semaines.
Quand le surcoût d'Opus est justifié
Le surcoût d’Opus se justifie dès que le coût d’une erreur dépasse largement l’écart de prix entre les deux modèles. C’est typiquement le cas des audits de sécurité ou des migrations critiques, réalisées via un accès via API dédié.
Le vrai coût caché : tokenisation et verbosité au-delà du prix par token
Le prix affiché par million de tokens ne raconte qu’une partie de l’équation budgétaire réelle. Cette section détaille un angle rarement traité, mais décisif pour votre facture finale.
Ce que le comportement du modèle change concrètement pour vos budgets
Deux modèles au même prix par token peuvent générer des factures très différentes selon leur verbosité naturelle. Un modèle qui produit des réponses plus longues consomme davantage de tokens de sortie, même sur une tâche identique.
Chez un client d’Anthropic spécialisé en droit, Opus 5 maintient la même qualité que la génération précédente. Il produit 26 % de tokens en moins qu’Opus 4.8, au niveau de raisonnement maximal. Ce type de gain d’efficacité pèse directement sur le coût réel, au-delà du simple tarif catalogue.
Comment mesurer le coût réel sur vos propres cas d'usage ?
La seule méthode fiable consiste à exécuter un échantillon représentatif de vos tâches sur chaque modèle, puis comparer la facture obtenue. Un test sur cinquante requêtes réelles donne une image bien plus fidèle qu’un simple calcul théorique sur le prix catalogue.
Comment utiliser Claude Opus et Sonnet ?
L’accès aux deux modèles varie selon votre profil, du particulier à l’entreprise structurée. Cette section détaille les canaux disponibles et leur intégration dans vos workflows en place.
Accéder à Opus et Sonnet
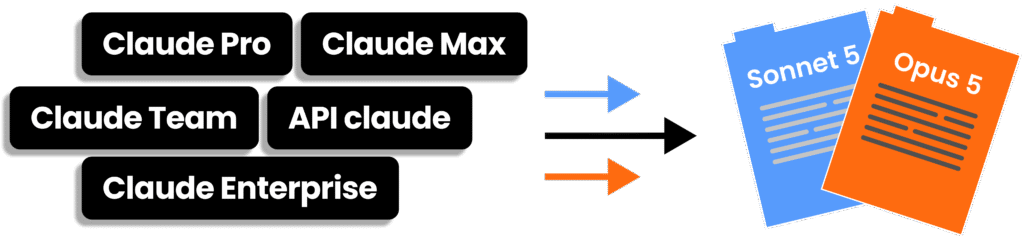
Les deux modèles sont accessibles sur Claude.ai via les offres Pro, Max, Team et Enterprise, ainsi que via l’API Claude native. Le plan Pro convient à un usage individuel régulier, tandis que Max offre un volume d’usage plus élevé pour les profils les plus intensifs.
Le plan Team, pensé pour les équipes de deux à cent cinquante personnes, ajoute une administration centralisée et un contrôle d’accès partagé. Le plan Enterprise apporte, en plus, un contrôle des dépenses par utilisateur, des journaux d’audit et une conformité renforcée.
Les deux modèles sont aussi disponibles sur Amazon Web Services, Google Cloud et Microsoft Foundry pour les équipes déjà engagées sur ces plateformes. Cette disponibilité multi-cloud facilite l’intégration dans une infrastructure existante, sans dépendance exclusive à un seul fournisseur.
Intégrer Sonnet dans un workflow quotidien
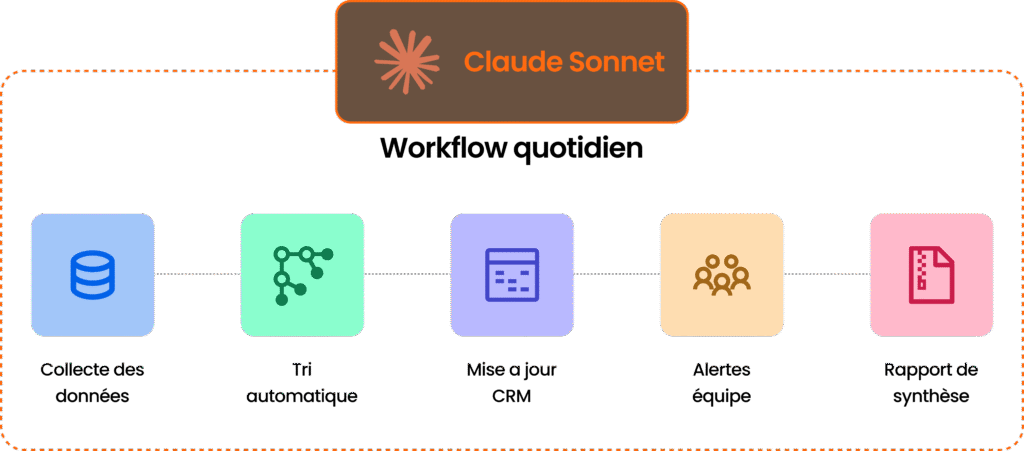
Sonnet s’intègre naturellement dans les tâches à haut volume comme la rédaction, l’analyse de documents ou l’automatisation légère de processus métier. Sa vitesse en fait un bon choix pour les agents autonomes qui traitent de nombreuses requêtes par jour.
Un cas fréquent chez nos clients consiste à brancher Sonnet sur une boîte de réception commerciale, pour qualifier et router automatiquement les demandes entrantes. Le modèle traite chaque message en quelques secondes, ce qui garde le processus fluide même sur un volume élevé.
Intégrer Opus dans un workflow avancé
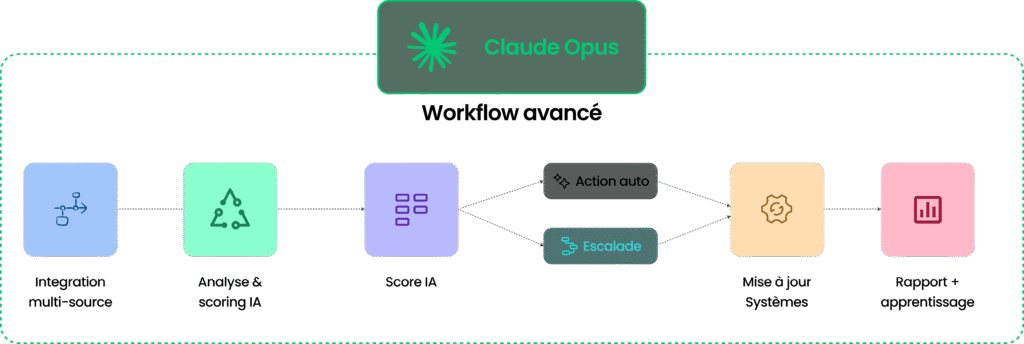
Opus trouve sa place sur les pipelines multi-étapes qui exigent un contrôle qualité poussé à chaque itération. Pour une équipe complète, cette intégration se pilote efficacement via un plan Team, avec une répartition claire entre les deux modèles selon les tâches.
Un usage avancé typique consiste à confier à Opus la supervision d’un agent multi-outils, chargé de coordonner plusieurs sous-tâches vers un objectif commun. Le modèle vérifie chaque étape intermédiaire, ce qui réduit fortement le risque d’erreur silencieuse sur un projet long.
Quel modèle choisir pour coder ?
Le codage reste l’un des usages les plus fréquents des deux modèles, avec des besoins très variables selon la complexité du projet. Cette section propose une règle pratique applicable immédiatement par votre équipe technique.
Sonnet pour le codage quotidien
Sonnet 5 couvre efficacement la complétion de code, le débogage courant et la revue de pull requests standards. Anthropic le positionne d’ailleurs comme un modèle à la précision d’agent comparable à la classe Opus sur plusieurs tâches, selon un retour client de Kiro.
Opus pour le codage complexe
Opus 5 prend l’avantage sur les grandes bases de code et les architectures multi-fichiers qui exigent une vision d’ensemble durable. Chez Cursor, il obtient un score proche de celui du modèle Fable, la gamme la plus avancée d’Anthropic, à un coût nettement inférieur.
La règle pratique
Commencez systématiquement par Sonnet sur toute nouvelle tâche de codage, puis escaladez vers Opus si le résultat manque de rigueur après une itération. Cette règle simple s’applique aussi bien dans Claude Code qu’en configuration API directe, et repose sur une bonne maîtrise du prompt engineering.
Besoin d'aide pour choisir entre Opus et Sonnet sur votre architecture de code ?
Notre équipe évalue votre codebase et vous recommande la répartition la plus rentable.
Comment nous combinons Opus et Sonnet chez nos clients : retour terrain
Sur les déploiements Claude accompagnés par Ethanolle, le choix du modèle n’est jamais binaire. Nos équipes appliquent un pattern d’escalade précis, ajusté à chaque client selon ses contraintes réelles.
Le pattern d'escalade que nous appliquons
Sonnet traite la tâche par défaut, sur l’ensemble des requêtes envoyées par nos clients. Un basculement automatique vers Opus se déclenche uniquement si un critère précis l’exige.
Trois critères pilotent cette escalade dans la majorité des déploiements que nous suivons. La durée de session compte en premier lieu. Une tâche qui dépasse plusieurs minutes de traitement continu déclenche alors le passage à Opus.
Le nombre de fichiers impliqués entre aussi en jeu. Un seuil au-delà de trois fichiers liés justifie alors la bascule vers Opus. Le niveau de raisonnement requis reste le troisième critère. Une tâche à enjeu élevé impose systématiquement Opus, quelle que soit sa durée.
Ce que ça change concrètement
Chez un client SaaS que nous accompagnons, ce pattern d’escalade a remplacé un usage systématique d’Opus sur l’ensemble des requêtes. Cette bascule a permis une économie d’environ 60 % sur la facture de tokens, sans perte de qualité perçue sur les livrables finaux.
Les utilisateurs de ce client n’ont signalé aucune dégradation notable, malgré le passage d’une majorité de requêtes vers Sonnet. Ce résultat confirme que la majorité des tâches quotidiennes ne justifie pas le surcoût d’Opus, même sur un produit à forte exigence de qualité.
Les critères d'escalade que nous recommandons
Le passage à Opus se justifie dès qu’une tâche implique un raisonnement multi-étapes difficile à vérifier a posteriori. Une architecture complexe, un audit de sécurité ou une analyse financière à fort enjeu entrent dans cette catégorie.
Sonnet reste préférable sur toute tâche courte, bien cadrée, où une erreur reste facile à détecter et corriger. La rédaction courante, le support client ou la complétion de code standard relèvent typiquement de ce cas.
Ce paramétrage se configure directement dans l’API Claude, via un routeur applicatif placé en amont de chaque requête. Le routeur évalue les critères définis plus haut, puis dirige automatiquement la requête vers le modèle adapté.
Le choix qui reste valable même quand Anthropic change de version
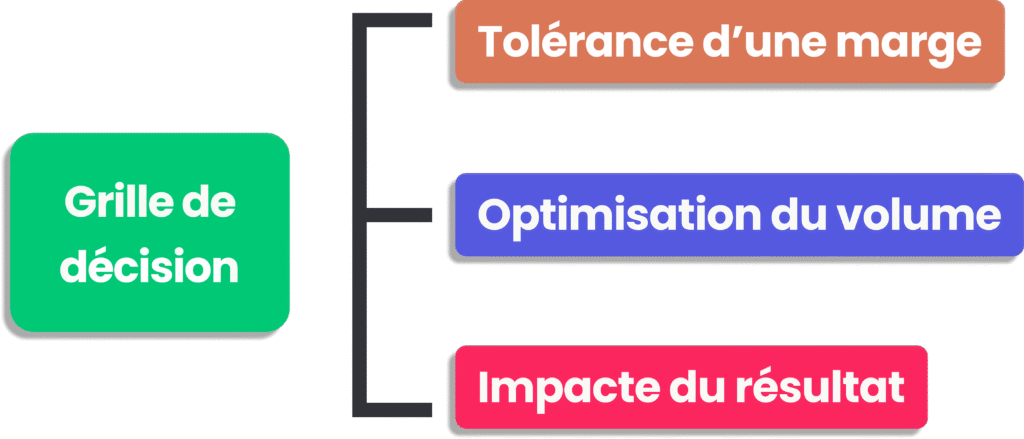
Anthropic a publié deux générations majeures de modèles Claude en moins d’un mois, entre juin et août 2026. Cette section propose une grille de décision qui reste pertinente indépendamment du numéro de version en vigueur.
Pourquoi comparer des numéros de version est un piège ?
Comparer uniquement des numéros de version rend votre choix rapidement obsolète, vu le rythme de sortie observé chez Anthropic depuis 2025. Une attention portée aux écarts de génération, plutôt qu’aux numéros de version, protège votre décision dans la durée.
Notre grille de décision indépendante de la version exacte
Posez-vous systématiquement trois questions avant de choisir un modèle, quelle que soit la génération disponible au moment de votre lecture.
- La tâche tolère-t-elle une petite marge d’erreur, ou exige-t-elle une fiabilité maximale à chaque étape ?
- Le volume de requêtes justifie-t-il une optimisation stricte du coût par token traité ?
- Le résultat final impacte-t-il directement un client, une décision financière ou une obligation légale ?
Ces trois questions restent valables d’une génération à l’autre, ce qui en fait un outil durable pour structurer votre déploiement de Claude AI en entreprise.
Ce que les benchmarks publics ne disent pas sur votre cas d'usage réel
Les scores affichés sur les pages officielles restent utiles, mais ils ne remplacent jamais un test sur vos propres données. Cette section rassemble ce que nos clients mesurent réellement en production, au-delà du marketing.
Ce que nos clients mesurent en production, au-delà des scores marketing
Un client du secteur financier que nous accompagnons a mesuré une précision supérieure de neuf points avec Opus. Cette mesure porte sur ses propres tâches de modélisation, comparées à la génération précédente. Le nombre d’itérations nécessaires a également chuté d’un tiers sur les mêmes tâches, avec un temps de traitement réduit d’environ 60 %.
Un client actif dans le commerce en ligne rapporte un constat différent, davantage centré sur la fiabilité que sur la précision brute. Son agent de gestion de compte, construit sur Opus, a identifié et traité l’intégralité d’une séquence de prévention de churn sans intervention humaine, là où les modèles précédents échouaient systématiquement sur cette même tâche.
Les écarts qui comptent vraiment selon votre secteur
Dans le secteur juridique, la précision prime largement sur la vitesse, ce qui pousse naturellement vers Opus dès que les enjeux contractuels deviennent significatifs. Un client juridique rapporte un score de relecture de première ligne presque deux fois supérieur avec Opus, comparé à la génération précédente.
Dans le support client, c’est l’inverse : la réactivité prime, ce qui favorise Sonnet dans la grande majorité des cas. Un temps de réponse de plusieurs secondes, tolérable sur une tâche d’analyse, devient rapidement problématique dans une conversation en direct avec un client.
Quand utiliser Opus plutôt que Sonnet ?
Certaines tâches justifient clairement le surcoût d’Opus, tandis que d’autres relèvent d’erreurs de configuration fréquentes. Cette section distingue les deux, pour éviter les pièges les plus courants observés chez nos clients.
Les tâches complexes qui justifient Opus
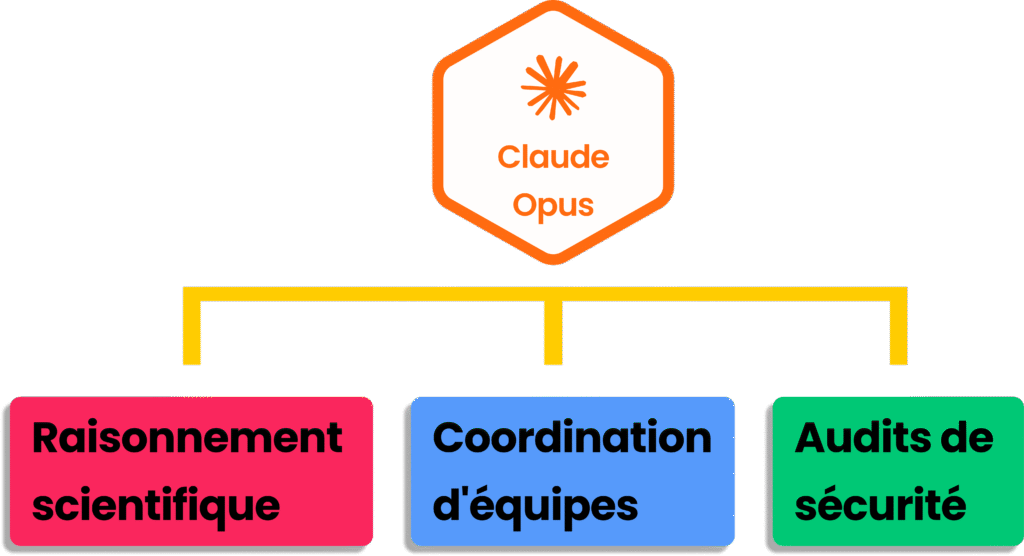
Le raisonnement scientifique poussé, la coordination d’équipes d’agents multiples et les audits de sécurité approfondis justifient naturellement le passage à Opus. La planification sur un horizon long, avec de nombreuses étapes interdépendantes, entre aussi dans cette catégorie.
Erreurs terrain observées
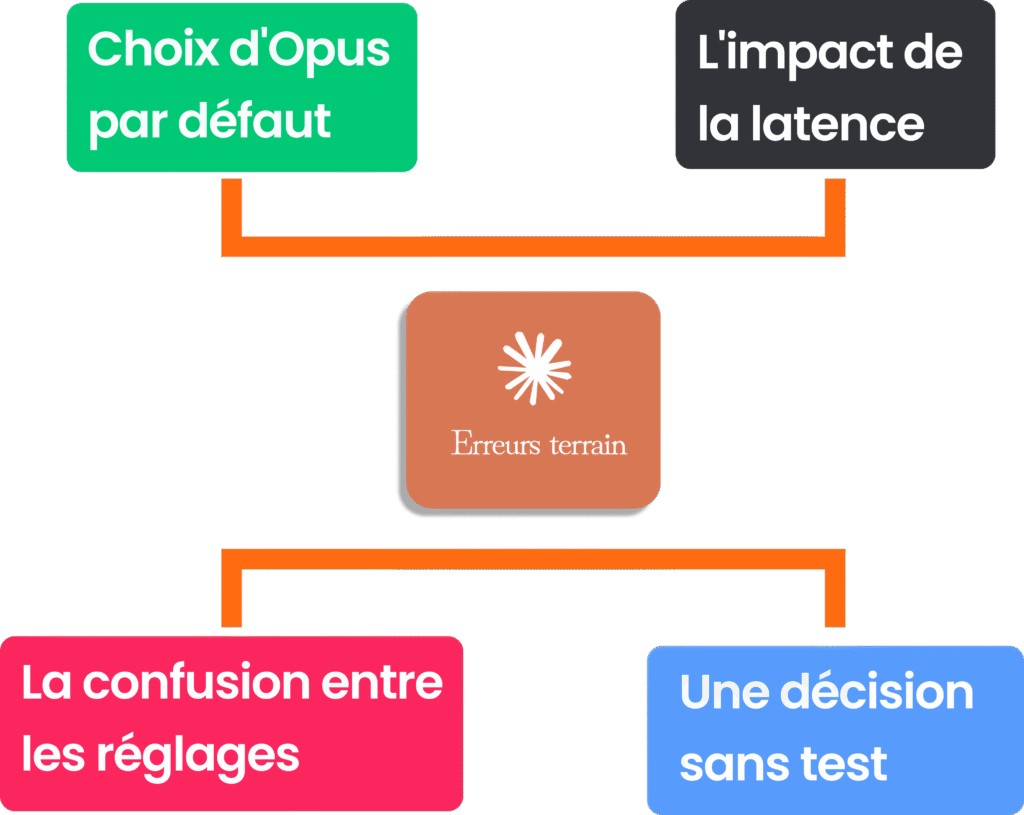
Certaines erreurs reviennent régulièrement chez les équipes qui découvrent Claude, au-delà du choix ponctuel entre Opus et Sonnet décrit dans la stratégie du routeur.
- Le choix d’Opus par défaut sur toutes les tâches génère un surcoût sans gain de qualité perceptible.
- L’impact de la latence d’Opus est souvent sous-estimé sur un workflow qui exige une réponse en temps réel.
- La confusion entre les réglages de raisonnement étendu propres à chaque modèle fausse la comparaison de résultats.
- Une décision fondée uniquement sur des benchmarks marketing, sans test sur ses propres cas d’usage, reste risquée.
Ces erreurs restent évitables dès lors qu’une équipe applique une méthode de test structurée avant tout déploiement à grande échelle.
Opus est-il meilleur que Sonnet ? Notre verdict par profil
Le meilleur modèle dépend entièrement de votre profil et de vos contraintes opérationnelles, pas d’un classement universel. Cette section synthétise notre recommandation pour les quatre profils que nous rencontrons le plus souvent.
Développeur solo ou freelance
Sonnet reste le choix par défaut pour un développeur solo, avec une bascule ponctuelle vers Opus sur les tâches longues et particulièrement complexes. Cet équilibre limite les coûts, avec une option de secours toujours disponible.
Un freelance qui facture au projet a tout intérêt à garder un œil sur la facture d’API, ce qui rend Sonnet particulièrement adapté à son usage quotidien. Opus reste utile ponctuellement, sur une migration technique ou un audit ponctuel facturé séparément au client.
Équipe technique en entreprise
Une équipe technique structurée gagne généralement à répartir sa charge entre les deux modèles. Une proportion proche de 80 % sur Sonnet et 20 % sur Opus, réservé aux agents critiques, fonctionne bien dans la plupart des cas. Cette répartition reprend directement la logique du routeur décrite plus haut.
Décideur non-technique
Un décideur non-technique peut s’appuyer sur Sonnet pour l’automatisation de tâches récurrentes, et réserver Opus aux analyses stratégiques qui exigent un raisonnement approfondi. Cette séparation simple facilite le pilotage budgétaire sans expertise technique poussée.
Un exemple courant consiste à confier à Sonnet la synthèse hebdomadaire d’indicateurs commerciaux, puis à réserver Opus pour une étude de marché ponctuelle avant une décision d’investissement.
Conformité RGPD
Les deux modèles offrent le même niveau de conformité RGPD, avec un accord de traitement des données identique et un hébergement soumis aux mêmes garanties. Le choix entre Opus et Sonnet n’a donc aucun impact sur votre conformité réglementaire lors d’un déploiement en entreprise.
Vous hésitez entre Opus et Sonnet pour votre équipe ?
On vous aide à trancher en 20 minutes, sur la base de vos cas d’usage réels.
FAQ – Claude Opus vs Sonnet
Quelle est la différence entre Claude Opus et Sonnet ?
Sonnet privilégie la vitesse et le coût maîtrisé pour les tâches à haut volume, tandis qu’Opus vise la profondeur d’analyse sur les tâches les plus critiques.
Quel modèle Claude choisir pour coder ?
Commencez par Sonnet pour le codage quotidien, puis basculez vers Opus dès qu’une base de code complexe exige davantage de rigueur et de cohérence.
Claude Opus est-il vraiment meilleur que Sonnet ?
Opus dépasse Sonnet sur les tâches longues et critiques, mais Sonnet reste souvent le choix le plus rentable pour la majorité des usages quotidiens.
Quel est le prix de Claude Opus et Sonnet ?
Sonnet 5 coûte 2,00 € en entrée et 10,00 € en sortie par million de tokens, contre 5,00 € et 25,00 € pour Opus 5.
Sonnet est-il plus rapide qu'Opus ?
Oui, et les offres Team et Enterprise permettent en plus à un administrateur de provisionner des compétences pour l’ensemble des collaborateurs de l’organisation.
Quand utiliser Opus plutôt que Sonnet ?
Utilisez Opus sur les tâches longues et à fort enjeu, comme les audits de sécurité, les architectures complexes ou les analyses stratégiques.
Faut-il changer d'avis à chaque nouvelle version de Claude ?
Non, la grille de décision par type de tâche reste valable d’une génération à l’autre, indépendamment du numéro de version en cours.
- Claude Science : l’atelier IA d’Anthropic pour accélérer la recherche
- IA responsable : ce que les entreprises doivent vraiment mettre en place
- L’agence IA pour automatiser et transformer votre entreprise
- Claude Opus vs Sonnet : ce que les benchmarks ne disent pas sur le bon choix
- CRM IA : ce que l’intelligence artificielle change vraiment dans votre gestion client
Rejoignez plus de 180 000 clients
qui font confiance à monday.com


Expert en intégration monday
Cofondateur de l’agence Ethanolle, Léo Darmon dirige les déploiements IA et monday.com chez Ethanolle, agence partenaire spécialisée dans l’industrialisation des plateformes collaboratives en entreprise. Il accompagne des DSI et CTO d’ETI françaises sur la sélection, le déploiement et la gouvernance d’outils IA depuis 2023.