
Déployez Claude AI en entreprise
Structurez vos usages pour sécuriser vos données et gagner en efficacité
Anthropic a publié quatre modèles majeurs en moins de deux mois entre juin et juillet 2026, un rythme inédit chez un éditeur d’intelligence artificielle. Face à cette accélération, choisir le bon modèle Claude devient une vraie question stratégique pour les équipes françaises qui déploient l’IA au quotidien. Notre guide complet sur Claude AI détaille déjà l’ensemble de l’écosystème de l’éditeur, cet article se concentre uniquement sur le choix du bon modèle.
Claude Opus 5, lancé le 24 juillet 2026, s’approche désormais de l’intelligence de Claude Fable 5 pour environ la moitié du prix facturé. Ce nouveau modèle dépasse déjà largement Opus 4.8 sur le code agentique, avec un score de 43,3 % sur le benchmark Frontier-Bench v0.1 selon Anthropic. Ce comparatif détaille chaque modèle disponible aujourd’hui sur claude.ai, ses forces réelles et le profil d’entreprise ou d’indépendant auquel il correspond le mieux en pratique.
Quels modèles Claude sont disponibles aujourd'hui ?
Anthropic organise désormais sa gamme en cinq niveaux distincts, du modèle le plus rapide jusqu’au plus capable de la famille. Cette hiérarchie va de Claude Haiku, pensé pour le traitement en volume, jusqu’à Claude Mythos, réservé à quelques organisations partenaires soigneusement sélectionnées. Cette logique en cinq étages mérite clairement d’être comprise avant tout choix de modèle pour votre activité professionnelle menée au quotidien.
Claude Haiku 4.5 : le modèle rapide et économique
Claude Haiku 4.5 reste le modèle le plus rapide et le moins onéreux de toute la gamme Anthropic actuellement disponible. Il coûte 0,87 € par million de tokens en entrée et 4,35 € en sortie selon la grille tarifaire officielle d’Anthropic. Ce modèle convient parfaitement aux chatbots à fort volume, à la modération de contenu automatisée et aux sous-agents parallélisés en production.
Claude Sonnet 5 : le modèle polyvalent par défaut
Claude Sonnet 5 demeure le modèle de référence pour un usage quotidien équilibré entre qualité de réponse et coût maîtrisé. Ce modèle traite aussi bien la rédaction de contenu, l’analyse de documents que la génération de code, sans changer d’outil.
Il facture 1,74 € par million de tokens en entrée et 8,70 € en sortie, un tarif nettement inférieur à celui d’Opus. La majorité des équipes françaises accompagnées par notre agence n’ont d’ailleurs jamais besoin de dépasser ce niveau de gamme intermédiaire.
Claude Opus 5 : le nouveau haut de gamme quotidien
Claude Opus 5 est arrivé le 24 juillet 2026 et remplace désormais Claude Opus 4.8 comme modèle par défaut sur l’abonnement Claude Max. Anthropic le présente comme un modèle réfléchi et proactif, capable d’itérer seul sur un problème jusqu’à obtenir un résultat fiable. Son prix reste identique à celui de son prédécesseur, soit 4,35 € en entrée et 21,75 € en sortie par million de tokens.
Claude Fable 5 et Claude Mythos 5 : les modèles de pointe sous conditions
Claude Fable 5 demeure le modèle public le plus capable, facturé 8,70 € en entrée et 43,50 € en sortie par million de tokens. Claude Mythos 5 partage le même socle technique, mais reste réservé aux organisations vérifiées dans le cadre du programme Project Glasswing d’Anthropic.
Les deux modèles ont connu une suspension d’accès entre le 12 et le 30 juin 2026, décidée par le département américain du Commerce. Anthropic a rétabli l’accès complet aux deux modèles dès le 1ᵉʳ juillet 2026, une fois la restriction officiellement levée par les autorités américaines.
Comparatif des modèles Claude : performances, vitesse et coût
Le choix d’un modèle Claude repose sur trois axes que la documentation officielle d’Anthropic met systématiquement en avant depuis plusieurs mois. La capacité de raisonnement, la vitesse de réponse et le coût par token forment un triangle où chaque modèle occupe une place précise et cohérente. Pour les lecteurs qui hésitent encore entre les deux écosystèmes concurrents, notre comparatif Claude vs ChatGPT détaille les écarts au-delà du seul choix de modèle.
| Modèle | Contexte | Forces principales | Vitesse et coût API | Disponibilité |
|---|---|---|---|---|
|
Haiku 4.5 |
200k tokens |
Rapidité, volume, sous-agents |
0,87 € / 4,35 € par MTok |
claude.ai, API, tous plans |
|
Sonnet 5 |
200k tokens |
Équilibre qualité/prix, codage |
1,74 € / 8,70 € par MTok |
claude.ai, API, tous plans |
|
Opus 5 |
200k tokens |
Code agentique, travail de la connaissance |
4,35 € / 21,75 € par MTok |
claude.ai, API, Max par défaut |
|
Fable 5 |
200k tokens |
Raisonnement de pointe, tâches longues |
8,70 € / 43,50 € par MTok |
Crédits d’usage, Pro et Max |
|
Mythos 5 |
200k tokens |
Cybersécurité, recherche sensible |
Sur demande commerciale |
Project Glasswing uniquement |
Sonnet 5 s’impose naturellement dès qu’un budget maîtrisé prime sur la puissance brute, un profil qui correspond à la majorité des usages courants. Claude Opus 5 devient réellement pertinent quand la profondeur du raisonnement conditionne directement la qualité finale du livrable produit pour le client. Fable 5 et Mythos 5 restent réservés aux organisations qui acceptent un coût plus élevé pour une intelligence de pointe.
Quel modèle Claude est le plus performant en 2026 ?
La notion de performance dépend entièrement du critère retenu, raisonnement pur, vitesse d’exécution ou rapport qualité-prix, selon le contexte précis d’utilisation. Un modèle peut dominer un benchmark de codage précis tout en restant moins pertinent qu’un concurrent moins cher au quotidien.
Claude Opus 5 : nouvel état de l'art du code agentique
Selon l’annonce officielle d’Anthropic, Opus 5 atteint 96 % sur le benchmark SWE-bench Verified, un score qui dépasse largement celui d’Opus 4.8. Sur la variante plus exigeante SWE-bench Pro, le modèle obtient 79,2 %, un résultat devant plusieurs concurrents directs présents sur le marché actuel. Ces résultats confirment sa position de nouveau modèle de référence pour les tâches de développement logiciel professionnel les plus complexes à traiter.
Claude Fable 5 : la capacité maximale de raisonnement
Claude Fable 5 conserve l’intelligence la plus élevée de toute la gamme Anthropic sur les tâches de raisonnement long et complexe. Opus 5 s’en rapproche fortement sur le codage, sans toutefois l’égaler totalement sur les scénarios les plus exigeants du marché. Le choix entre les deux modèles dépend surtout du budget disponible pour chaque projet et de sa criticité métier réelle.
Performances en agentic coding : quel modèle domine vraiment ?
Sur le benchmark Frontier-Bench v0.1, Opus 5 atteint 43,3 %, soit plus du double du score obtenu par son prédécesseur Opus 4.8. Sur le nouveau test d’autonomie informatique OSWorld 2.0, le modèle dépasse la totalité de ses concurrents directs avec un score de 70,6 %.
Ces chiffres placent aujourd’hui Opus 5 devant la plupart des modèles rivaux actuellement disponibles sur les tâches agentiques de longue durée. Au sein de la gamme Anthropic, Opus 5 devance nettement Sonnet 5 sur ces deux benchmarks, et s’approche désormais du score de Fable 5.
Analyse critique : benchmark terrain contre communication Anthropic
En tant que partenaire certifié Anthropic, notre équipe teste chaque nouveau modèle sur des projets clients réels avant toute recommandation officielle publiée. Les scores communiqués par Anthropic reflètent des conditions de test optimisées, alors que nos déploiements terrain montrent parfois des écarts selon le prompt initial. Un modèle brillant sur un benchmark académique standardisé ne garantit jamais une supériorité automatique sur un cas d’usage métier précis et concret.
Quel modèle Claude choisir pour un usage quotidien ?
Pour la grande majorité des utilisateurs professionnels, le choix du quotidien ne se porte pas naturellement vers le modèle Opus. Sonnet 5 couvre l’essentiel des besoins professionnels courants sans jamais sacrifier la qualité de sortie attendue sur les tâches habituelles.
Claude Sonnet 5 : le choix par défaut du travail courant
Claude Sonnet 5 gère efficacement la rédaction de contenu, l’analyse de documents et les échanges conversationnels de longueur moyenne au quotidien. Son coût réduit permet un usage intensif sans faire exploser le budget mensuel alloué à l’intelligence artificielle par une équipe. La plupart des consultants et chargés de projet accompagnés par Ethanolle n’ont besoin d’aucun autre modèle pour leur activité courante.
Claude Opus 5 : quand la profondeur de raisonnement compte
Certaines tâches exigent un niveau de réflexion que Sonnet ne fournit pas toujours avec la même fiabilité constante et mesurable. Une analyse financière complexe, un audit juridique détaillé ou un projet de code multi-fichiers justifient souvent le passage à Opus. Le surcoût reste globalement raisonnable face au gain de qualité réellement obtenu sur ce type de mission particulièrement exigeante pour l’entreprise.
Sonnet 5 ou Opus 5 : le verdict tranché
Sonnet suffit largement dès que la tâche demandée reste standard, répétitive ou peu exigeante en termes de raisonnement multi-étapes enchaînées. Opus s’impose dès que l’enjeu financier ou stratégique de la tâche justifie un coût par token cinq fois supérieur à celui de Sonnet. Cette règle simple évite la plupart des erreurs de surdimensionnement budgétaire que nous observons régulièrement chez nos clients accompagnés au quotidien.
Quand passer à un modèle supérieur ?
Le signal le plus fiable reste la répétition d’erreurs de raisonnement observées sur une même famille de tâches confiées à Sonnet. Dès qu’un projet implique plusieurs documents croisés ou un raisonnement en plusieurs étapes interdépendantes, Opus devient réellement pertinent à considérer. Un test comparatif mené sur un échantillon réduit de vos propres prompts reste la méthode la plus fiable pour trancher.
Quel modèle Claude choisir pour le codage et le développement web ?
Le développement logiciel reste le domaine où le choix du modèle influence le plus directement la qualité finale du résultat livré. Génération de composants, débogage approfondi, tests automatisés et documentation technique ne demandent pas toujours exactement le même niveau de puissance disponible.
Claude Opus 5 : génération de code complexe et refactoring
Claude Opus 5 excelle particulièrement sur les refactorings de grande ampleur et les architectures logicielles qui impliquent de nombreux fichiers interdépendants entre eux. Anthropic rapporte des cas où le modèle a construit spontanément son propre pipeline de vision par ordinateur pour résoudre un problème inédit. Notre équipe recommande vivement ce modèle dès qu’un projet dépasse quelques centaines de lignes de code métier réellement critique pour l’activité.
Claude Sonnet 5 : équilibre performance et coût pour les développeurs
Pour les tâches de développement courantes, correction de bugs simples et génération de tests unitaires, Sonnet 5 reste largement suffisant au quotidien. Son coût cinq fois inférieur à celui d’Opus permet une utilisation intensive continue sans surveiller étroitement chaque appel API facturé. Notre guide sur le déploiement de Claude détaille la configuration technique recommandée pour équiper une équipe de développement complète et opérationnelle.
Workflow agentique et Claude Code : quel modèle en production ?
Claude Code s’appuie par défaut sur Sonnet 5 pour la majorité des tâches courantes, avec bascule automatique vers Opus si nécessaire. Cette architecture hybride optimise le coût global d’un projet tout en garantissant un niveau de qualité constant et prévisible sur la durée du projet. Un prompt engineering rigoureux améliore encore sensiblement la fiabilité du résultat obtenu, quel que soit le modèle finalement choisi par l’équipe en charge du projet.
Cas particulier : génération et débogage HTML, CSS et JavaScript
Pour la production de landing pages et d’interfaces front-end relativement simples, Sonnet 5 traite l’essentiel des demandes courantes avec efficacité. Le passage à Opus se justifie surtout sur des interfaces complexes impliquant une logique métier lourde et difficile à maintenir côté client final. Le débogage de bugs visuels difficiles à reproduire bénéficie souvent d’un raisonnement plus approfondi qu’Opus fournit naturellement mieux que les autres modèles.
Vous intégrez Claude dans votre stack de développement ?
Un audit technique gratuit permet d’identifier le modèle le plus rentable pour chacun de vos cas d’usage précis.
Comment choisir un modèle Claude selon vos critères ?
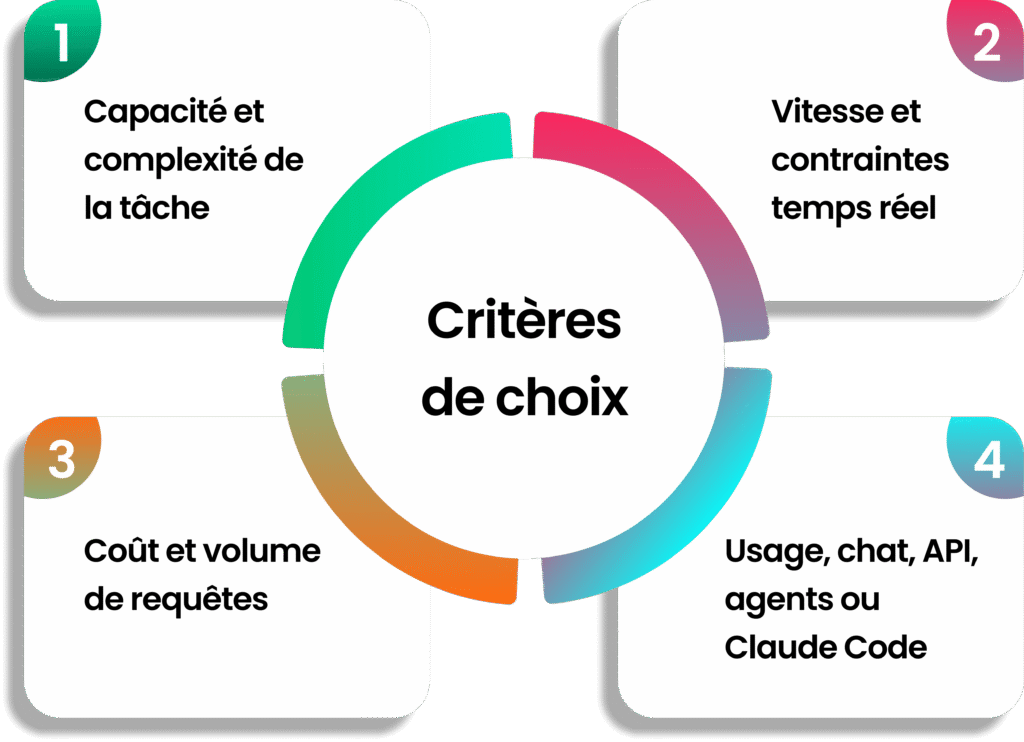
Le choix d’un modèle Claude revient concrètement à prioriser l’un des quatre critères suivants selon votre contexte métier précis et vos contraintes budgétaires actuelles. Cette grille de décision simplifie un choix qui paraît complexe au premier abord face à cinq modèles disponibles aujourd’hui sur le marché français.
Critère 1 : capacité et complexité de la tâche
Plus une tâche implique d’étapes de raisonnement enchaînées les unes aux autres, plus un modèle haut de gamme comme Opus devient pertinent. Une tâche simple et bien cadrée en amont ne justifie presque jamais le coût supplémentaire d’un modèle supérieur à Sonnet.
Critère 2 : vitesse et contraintes temps réel
Les applications conversationnelles à fort trafic, support client ou chatbot public, exigent une latence minimale et un coût strictement contrôlé. Haiku 4.5 reste ici le choix le plus cohérent disponible, malgré une capacité de raisonnement plus limitée que ses grands frères.
Critère 3 : coût et volume de requêtes
Un volume élevé de requêtes quotidiennes multiplie rapidement la facture globale, même avec un modèle économique comme Haiku ou Sonnet. Le calcul précis du coût mensuel réel avant tout déploiement en production évite les mauvaises surprises budgétaires en fin de mois.
Critère 4 : usage, chat, API, agents ou Claude Code
Un usage conversationnel classique sur claude.ai, via le chat quotidien, s’accommode généralement très bien de Sonnet 5 pour la plupart des utilisateurs. L’intégration via l’API Claude change la donne, chaque appel étant facturé au token selon le modèle sélectionné pour la tâche technique visée par le développeur.
Un agent autonome de longue durée, qui exécute plusieurs actions enchaînées sans supervision constante, bénéficie nettement davantage d’Opus 5 qu’un simple chat ponctuel. Claude Code, l’outil dédié au développement en ligne de commande, s’appuie par défaut sur Sonnet 5 avec bascule automatique vers Opus. Notre atelier productivité Claude aide justement les équipes à cartographier précisément leurs usages avant de fixer une architecture de modèles pérenne.
Tarifs des modèles Claude : API et abonnements
Anthropic propose deux modes d’accès bien distincts à ses modèles, un abonnement claude.ai grand public et une facturation API strictement à l’usage. Cette différence fondamentale mérite d’être comprise pour éviter de payer deux fois le même service technique sans même s’en rendre compte.
Tarifs API par modèle
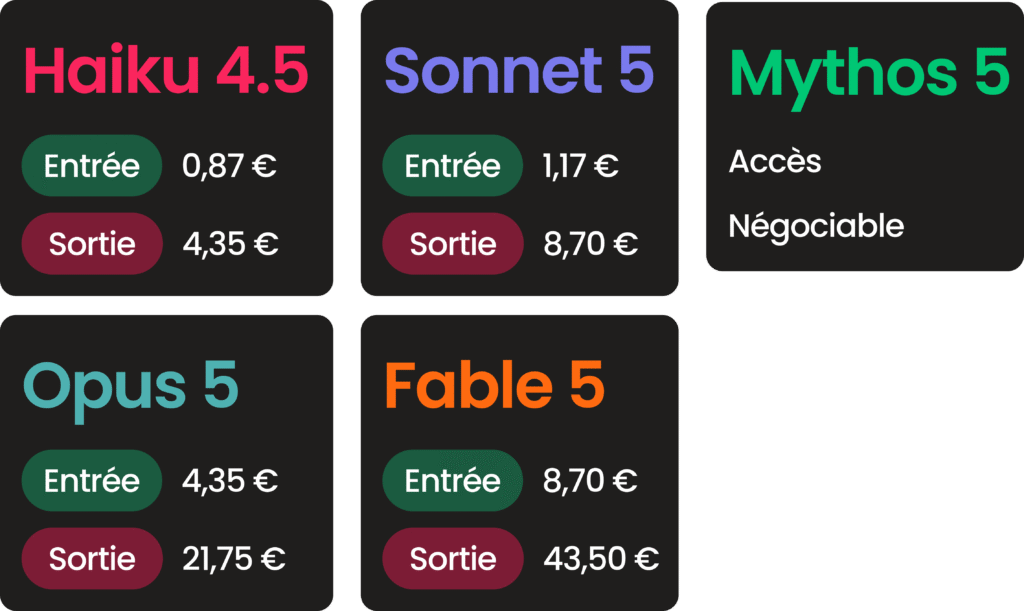
Les tarifs API sont facturés au million de tokens, avec un prix différent selon que les tokens sont en entrée ou en sortie du modèle. Haiku 4.5 coûte 0,87 € en entrée et 4,35 € en sortie, le tarif le plus accessible de toute la gamme actuelle.
Sonnet 5 facture 1,74 € en entrée et 8,70 € en sortie, un positionnement intermédiaire cohérent avec son usage quotidien recommandé. Opus 5 reste à 4,35 € en entrée et 21,75 € en sortie, un tarif identique à celui de son prédécesseur Opus 4.8.
Fable 5 conserve le tarif le plus élevé de la gamme, 8,70 € en entrée et 43,50 € en sortie par million de tokens traités. Claude Mythos 5 n’affiche aucun tarif public : son accès se négocie directement avec Anthropic via le programme fermé Project Glasswing réservé aux organisations vérifiées.
Abonnements claude.ai : Free, Pro, Max, Team et Enterprise
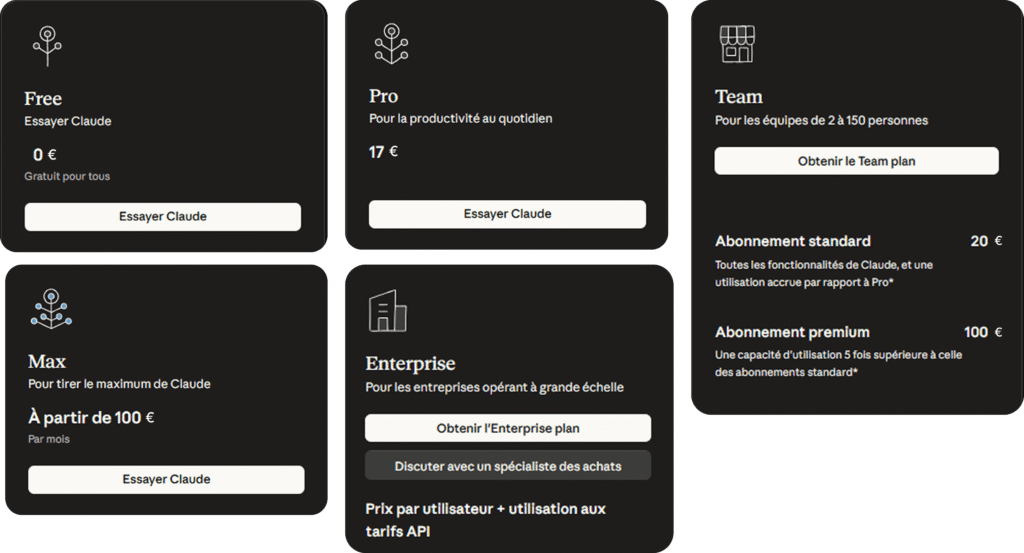
Le plan Free reste entièrement gratuit et donne accès aux fonctionnalités de base, sans les modèles les plus avancés de la gamme. Notre guide sur l’accès gratuit à Claude détaille précisément les limites d’usage appliquées concrètement à ce plan d’entrée gratuit proposé par Anthropic.
Le plan Pro démarre à 14,79 € par mois en facturation annuelle et débloque Claude Code ainsi que davantage de modèles disponibles. Le plan Max, à partir de 87 € par mois, cible les utilisateurs intensifs avec cinq à vingt fois plus d’usage que Pro. Les plans Claude Team et Claude Enterprise ajoutent une administration centralisée complète, adaptée aux organisations de toute taille, y compris les très grandes entreprises internationales.
Erreurs fréquentes dans le choix d'un modèle Claude
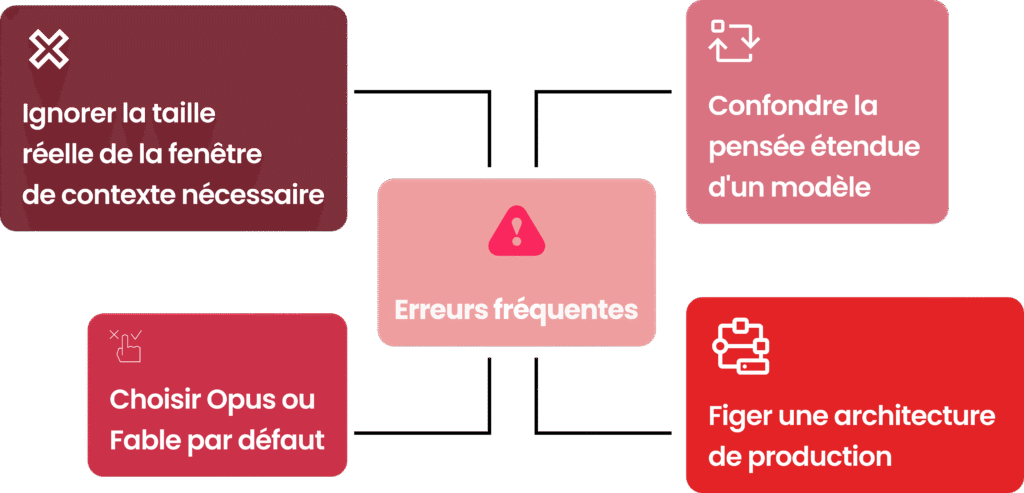
Nos déploiements clients chez des PME et grandes entreprises françaises révèlent des erreurs récurrentes dans le choix d’un modèle Claude adapté. En tant que partenaire certifié Anthropic, notre équipe observe ces mêmes erreurs se répéter d’un projet à l’autre depuis plusieurs mois consécutifs.
La première erreur consiste à choisir Opus ou Fable par défaut pour la qualité perçue, sans jamais tester Sonnet sur la même tâche au préalable. Ce réflexe génère un surcoût important sans aucun gain de qualité réellement mesurable sur des tâches simples et répétitives menées au quotidien.
La deuxième erreur ignore la taille réelle de la fenêtre de contexte nécessaire selon la nature exacte de la tâche traitée. Un document volumineux mal découpé en amont sature rapidement le contexte disponible, quel que soit le modèle finalement choisi pour la tâche.
La troisième erreur confond la pensée étendue d’un modèle avec une réponse standard classique, un impact souvent largement sous-estimé sur le budget final. L’activation systématique de ce mode sur des tâches simples multiplie inutilement le coût par requête, sans le moindre bénéfice réel constaté.
La quatrième erreur consiste à figer une architecture de production sans avoir testé plusieurs modèles sur un échantillon représentatif de vos cas d’usage réels.
Besoin d'aide pour choisir le bon modèle Claude pour votre stack ?
Notre équipe compare gratuitement vos cas d’usage sur les cinq modèles disponibles avant toute recommandation.
Meilleur modèle Claude en entreprise : ce que nous recommandons
Cette recommandation s’appuie sur nos déploiements réels chez des entreprises françaises, en tant que partenaire certifié Anthropic depuis plusieurs mois maintenant. Chaque contexte client reste unique, mais trois grandes règles reviennent systématiquement dans l’ensemble de nos audits clients réalisés depuis plusieurs mois.
Sonnet 5 pour la majorité des équipes
Sonnet 5 couvre entre 70 et 80 % des besoins observés chez nos clients, tous secteurs d’activité confondus selon notre expérience terrain accumulée. Ce modèle représente donc aujourd’hui le choix par défaut le plus rationnel pour équiper une équipe sans exploser le budget alloué à l’IA.
Opus 5 pour les agents autonomes et les tâches complexes
Opus 5 devient particulièrement pertinent dès qu’un agent doit fonctionner en autonomie prolongée sur une tâche métier à forte valeur ajoutée. Notre page dédiée à Claude en entreprise détaille précisément les architectures d’agents que nous déployons régulièrement chez nos clients grands comptes.
Haiku 4.5 pour les automatisations en volume
Haiku 4.5 s’impose naturellement pour les automatisations répétitives à fort volume, classification de tickets, extraction de données ou modération de contenu. Son coût réduit permet un déploiement à grande échelle sans jamais compromettre la rentabilité globale du projet d’automatisation mis en place.
FAQ – Meilleur modèle Claude
Quel est le modèle Claude le plus puissant en 2026 ?
Claude Fable 5 reste le modèle public le plus capable sur le raisonnement pur, devant Opus 5 sur les tâches les plus complexes. Claude Mythos 5 le dépasse spécifiquement sur la cybersécurité, mais demeure réservé aux organisations vérifiées et formellement approuvées par les équipes d’Anthropic.
Quel est le dernier modèle Claude sorti en 2026 ?
Claude Opus 5, publié officiellement le 24 juillet 2026, est à ce jour le dernier modèle majeur lancé par Anthropic. Il devient le modèle par défaut sur Claude Max et le plus puissant disponible sur l’abonnement Claude Pro depuis fin juillet 2026.
Claude Sonnet est-il meilleur que Claude Opus ?
Sonnet n’est pas objectivement meilleur qu’Opus en termes de capacité brute, mais il offre un rapport qualité-prix nettement supérieur pour un usage quotidien standard. Opus reste préférable dès que la complexité réelle de la tâche justifie pleinement son coût plus élevé par rapport à Sonnet.
Quel modèle Claude est disponible gratuitement ?
Le plan Free de claude.ai donne accès à Claude sans les modèles les plus avancés de la gamme actuelle d’Anthropic. Une capacité d’usage limitée s’applique également à ce plan, réservé aux besoins ponctuels plutôt qu’à un usage professionnel intensif mené au quotidien.
Quelle différence entre Claude Fable et Claude Mythos ?
Fable 5 et Mythos 5 partagent le même socle technique sous-jacent, avec des mesures de sécurité renforcées appliquées côté Mythos. Mythos reste réservé au programme Project Glasswing, tandis que Fable demeure accessible via les abonnements Pro et Max classiques proposés par Anthropic.
Quel modèle Claude choisir pour coder ?
Sonnet 5 convient à la majorité des tâches de développement courantes, tandis qu’Opus 5 s’impose sur les refactorings complexes et multi-fichiers. Le choix final dépend surtout de la taille du projet et de sa criticité métier pour l’entreprise concernée par le développement.
Comment accéder à Claude Opus 5 via l'API ?
L’accès s’effectue via la plateforme développeur d’Anthropic, avec une facturation de 4,35 € en entrée et 21,75 € en sortie par million de tokens. Aucune inscription à un programme fermé n’est nécessaire pour Opus 5, contrairement au modèle Mythos, réservé au programme fermé Project Glasswing d’Anthropic.
Comment choisir entre les cinq modèles Claude disponibles ?
Le choix dépend de quatre critères combinés, la complexité de la tâche, la vitesse requise, le budget disponible et le contexte d’usage final visé. Notre grille de décision détaillée plus haut dans cet article couvre en détail chacun de ces quatre critères essentiels à connaître.
- Claude Science : l’atelier IA d’Anthropic pour accélérer la recherche
- IA responsable : ce que les entreprises doivent vraiment mettre en place
- L’agence IA pour automatiser et transformer votre entreprise
- Claude Opus vs Sonnet : ce que les benchmarks ne disent pas sur le bon choix
- CRM IA : ce que l’intelligence artificielle change vraiment dans votre gestion client
Rejoignez plus de 180 000 clients
qui font confiance à monday.com


Expert en intégration monday
Cofondateur de l’agence Ethanolle, Léo Darmon dirige les déploiements IA et monday.com chez Ethanolle, agence partenaire spécialisée dans l’industrialisation des plateformes collaboratives en entreprise. Il accompagne des DSI et CTO d’ETI françaises sur la sélection, le déploiement et la gouvernance d’outils IA depuis 2023.


